한 줄 요약: VLA가 틀리는 건 '어디서'뿐, 엔드이펙터를 올바른 대상 앞에 데려다주면 기존 스킬로 해결함
🧩 VLA(Vision-Language-Action)는 카메라 영상과 언어 지시를 받아 로봇 행동을 바로 출력하는 모델임. 하지만 로봇 데이터에서는 물체·목적지·배경이 늘 같은 조합으로 나와서, 이미 본 요소를 새로 조합(Recomposition)하기만 해도 정책이 익숙한 시각 단서를 따라가 엉뚱한 물체를 집음. 기존 해법은 조합을 늘린 데이터 수집, 백본별 구조 수정 후 재학습, 외부 플래너·스코어러 기반 추론 시 조향(Steering)이었고, 모두 비용이 크거나 정책이 고려하지 않은 대상으로는 손을 옮겨주지 못함.
이 논문은 "조합이 바뀌었을 때 VLA는 '어디서(WHERE)' 행동할지를 잘못 잡을 뿐 '어떻게(HOW)' 조작할지는 잃지 않으므로, 올바른 대상의 시연 기반 접근 자세로 데려다주기만 하면 동결된 정책이 그대로 작업을 완수한다"는 원리를 증명함!
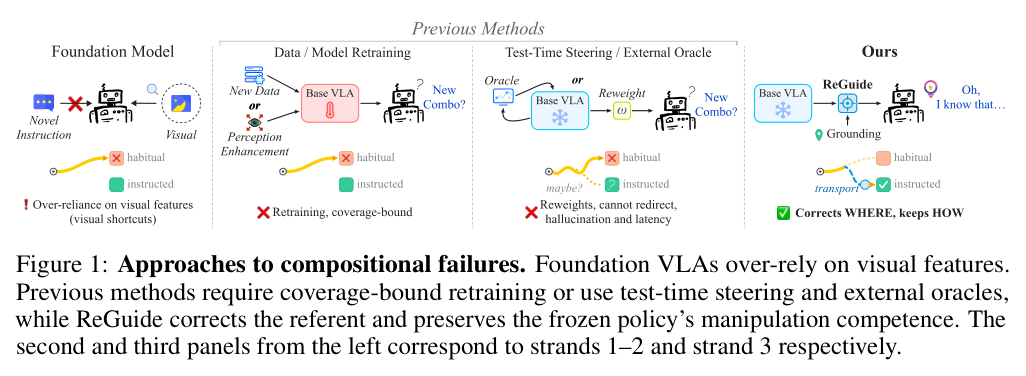
▲ Figure 1 · 데이터 재수집·재학습·외부 오라클 방식과 대비한 ReGuide의 접근법
💡 핵심 기술 요약
🎯 Semantic Rebinding: 정책이 아직 실행하지 않은 액션 청크로 손이 향하는 대상을 예측해, 지시된 대상과 어긋나면 외부 스코어러 없이 개입 신호를 냄.
📐 Geometric Rebinding: 학습 시연에서 뽑은 물체별 접근 위치·자세를 정답 대상의 좌표계로 옮겨, 정책이 이어받을 수 있는 Pre-contact Set을 만듦.
🔁 Training-free Hand-back: 시연 범위로 제한된 이동으로 엔드이펙터를 데려간 뒤 동결 정책에 제어를 돌려주는, 백본 무관한 학습 불필요 래퍼.
🔍 방법 자세히 보기
🧮 문제 정의: 바인딩 × 숙련도 분해
동결된 VLA 정책은 관측과 지시를 받아 액션 청크(이동·회전·그리퍼 명령)를 출력하고, 지시는 '어떤 물체를 어느 목적지로'처럼 잡기·놓기 단계로 나뉨. 논문은 각 단계 성공 확률을 '올바른 대상의 접근 영역에 들어갈 확률(Binding)'과 '들어간 뒤 완수할 확률(Competence)'의 곱으로 분해함. 조합이 바뀌면 Binding이 무너질 뿐 Competence는 상당 부분 남아 있다는 관찰에서 출발해, 목표를 '정책의 로컬 스킬이 다시 작동하는 상호작용 구성으로의 접근 회복'으로 둠. 그라운딩 모듈이 지시 대상의 포즈와 바운딩 박스를 제공하고, 정책 학습에 쓰인 시연 데이터의 분위수(Q.5는 목표, Q.95/Q.05는 상·하한, Q.25는 커밋 임계값)를 모든 기준값으로 공통 사용함.
🔍 Semantic Rebinding: 정책이 어디로 가려는지 읽기
먼저 첫 프레임과 가장 가까운 학습 장면을 동결 이미지 인코더로 찾아, 그 장면에서 자주 다뤄진 물체·목적지를 습관적 후보(Habitual Set)로 묶음. 정책의 남은 액션 청크를 시연에서 맞춘 제어 스케일·추종 게인으로 적분해 예상 도착점과 자세를 계산하고, 그 지점이 어떤 후보의 박스로 시연 기반 커밋 반경 안에 진입하는지 판정함. 정책이 고른 대상이 지시 대상과 다르고 아직 접촉 전이면 개입을 걸어, 실패가 일어나기 전에 미리 감지함. 대상이 맞더라도 자세 오차가 시연 허용치를 넘거나 N 스텝 동안 진척이 없으면(Failure to Bind) 개입하고, 학습 때 본 적 없는 물체는 첫 결정부터 바로 안내함.
📦 Geometric Rebinding: 시연 자세를 새 대상에 이식
시연을 물체 타입·목적지 클래스별로 묶고, 잡는 순간의 포즈를 중력 정렬된 물체 정규 좌표계(넓은 수평축·수직축 기준)로 표현함. 윗면 중심 기준 중앙값 잡기 오프셋, 회전 메도이드, 중앙값 진입 높이를 결합해 목표 위치·자세를 계산함. 정책에 넘겨줄 Pre-contact Set은 위치가 한 스텝 이동량 이내, 접근축 수직 방향 오차가 잡기 산포 이내, 자세 오차가 시연 회전 잔차 이내인 영역으로 정의함(평행 그리퍼의 반바퀴 대칭 고려). 처음 보는 물체는 높이·두 폭·윗면 채움 비율의 로그 디스크립터가 가장 가까운 학습 타입의 통계를 물려받음. 놓기 단계는 목적지 프레임의 중앙값 릴리스 오프셋과, 거리 대비 물체 바닥 높이 프로파일(중앙값·하한 포락선)을 이용함.
🚚 Bounded Transport와 Hand-back
ReGuide는 시연의 스텝당 이동·회전량 상한(Q.95)으로 잘라낸 직선형 이동 명령으로 엔드이펙터를 목표로 운반하고, 제어 스케일과 추종 게인으로 나눠 실제 움직임을 맞춤. 물체를 든 채 이동할 때는 높이를 중앙값 프로파일에 맞추되 중간 장애 구간의 하한 포락선으로 바닥을 깔아, 시연처럼 '먼저 들고 그다음 옮기는' 순서를 따름. Pre-contact Set에 진입하면 대기 중인 청크를 버리고 실제 관측으로 동결 정책을 다시 호출해 제어권을 넘김. 이는 정책 출력을 재가중하는 대신 정책이 원래 잘하는 상태로 되돌려 주려는 설계임.
🛟 실행 조율과 복구
제어권을 넘긴 뒤에도 같은 시연 기준이 작동해, 하강 중에는 측면 허용치로, 운반 중에는 높이 바닥으로 정책 행동을 제한함. 잡기·떨어뜨림 같은 전제가 바뀌거나 n번 재계획 동안 오차가 줄지 않으면 운반을 해제하고, 단계당 운반은 최대 2회로 제한함. Completion Certificate가 목적지 상실, 허용 영역 밖 릴리스, 운반·배치 중 진척 부족을 감시해 운반을 재가동하거나, 물체가 허용 영역 안에서 시연 체류 시간 이상 머물면 시연 높이에서 하강·릴리스를 마무리함. 학습·가중치 수정·디코딩 변경이 전혀 없는 추론 시점 래퍼로 동작함.
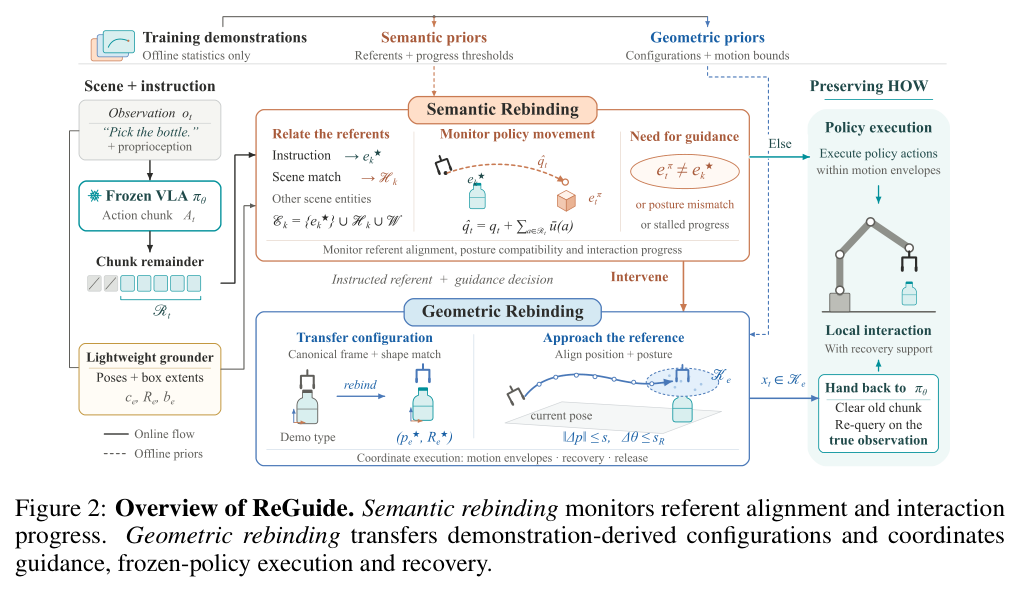
▲ Figure 2 · 대상 정렬을 감시하는 Semantic Rebinding과 자세 이식·실행 조율의 Geometric Rebinding
🧪 실험 설정
- 🧪 벤치마크: LIBERO 기반으로 한 번에 한 요소만 바꾸는 조합 벤치마크를 구축함. Target Region·Target Object·Unseen Object·Task Scene 4축 × 4태스크 = 16개 셀과 원본 10개 태스크(Orig.), 셀당 동일한 50개 초기 상태로 방법당 1300개 쌍 비교 시행.
- 🤖 로봇/환경: UFACTORY xArm6에 베이스·손목 RGB-D 카메라를 달고, π0.5를 3개 pick-and-place·2개 push 태스크의 스크립트 시연 250개로 파인튜닝함. 학습 조합 5개, 재조합 8개, 처음 보는 물체 2개 등 15개 셀 × 10 레이아웃 = 방법당 150회 시행.
- ⚖️ 비교 대상: OpenVLA-OFT, π0, π0.5, X-VLA, GR00T N1.7 등 5개 백본과 OTTER, GuidedVLA, APT, CAG 등 그라운딩·지시 추종 강화 방법 4종, 그리고 에이전트 기반 Harness VLA를 별도로 비교함.
- 📏 평가 지표 및 그라운딩: 성공률(%)에 95% Wilson 신뢰구간을 붙이고, 쌍 비교는 McNemar exact test로 검정함. 시뮬레이션은 오라클 시뮬레이터 상태와 지각 기반 그라운딩을 모두 평가하고, 실로봇은 개방 어휘 검출기와 깊이, 측정한 물체 치수를 사용함.
📊 주요 결과
🚀 백본 불문 조합 성공률 대폭 상승: ReGuide는 3개 백본 모두에서 Comp. Avg.를 55.5~56.8%p 올렸고, Orig. 변화는 최대 0.8%p에 그침. π0.5 기준 39.0% → 94.5%, OpenVLA-OFT 14.0% → 70.8%, GR00T N1.7 13.0% → 69.1% 달성.
🥊 기존 조합 일반화 기법 대비 우위: 가장 강한 비교 대상 CAG(π0.5)는 Comp. Avg.를 39.0%에서 41.4%로 올리는 데 그치면서 Orig.는 94.0%에서 81.4%로 떨어뜨림. ReGuide(π0.5)는 4개 축 모두 93.0~96.0%를 기록함.
🦾 실로봇 재조합 15.0% → 90.0%: xArm6에서 재조합 성공률이 15.0%에서 90.0%로 75.0%p 올랐고, 쌍 비교 기준 75승 0패를 기록함. 원본 태스크도 86.0%에서 92.0%로 올랐고, push 재조합은 0/20에서 20/20이 됨.
👁️ 지각 기반 그라운딩·런타임: 오라클 대신 지각 기반 그라운딩을 써도 π0.5 조합 성공률이 87.5%로, 오라클 대비 7.0%p 낮지만 원래 정책보다 48.5%p 높음. 재계획 지연 중앙값은 129.2ms로 원래 정책(129.0ms)과 같고, Harness VLA는 플래너 응답마다 중앙값 6.1s를 기다리며 에피소드당 GPT-5.5 API 비용이 평균 $1.84 듦.
| Method | Orig. (%) | Target Object (%) | Task Scene (%) | Comp. Avg. (%) |
|---|---|---|---|---|
| π0.5 | 94.0 | 25.0 | 41.0 | 39.0 |
| APT | 91.4 | 33.5 | 1.5 | 24.4 |
| CAG (π0.5) | 81.4 | 35.0 | 33.5 | 41.4 |
| ReGuide (OpenVLA-OFT) | 96.8 | 49.0 | 74.5 | 70.8 |
| ReGuide (π0.5) | 94.2 | 93.0 | 94.5 | 94.5 |
| ReGuide (GR00T N1.7) | 94.2 | 52.5 | 96.0 | 69.1 |
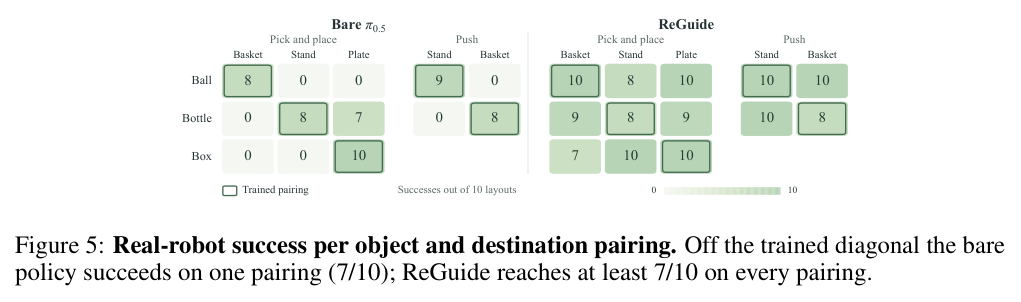
▲ Figure 5 · 실로봇 물체-목적지 조합별 성공률, ReGuide는 모든 조합 7/10 이상
🔬 분석 & Ablation
🔬 로컬 스킬은 살아 있고, 정책 행동이 핵심: 엔드이펙터를 지시 물체의 pre-contact 목표로 옮긴 뒤 추가 안내 없이 π0.5를 돌리자, 재조합 8개 셀의 잡기 성공률이 64.5%에서 95.8%로 오름. 반대로 hand-back 이후 VLA 행동을 기본 하강·잡기 동작이나 정지 동작으로 바꾸면 성공률이 94.5%에서 38.1%, 28.0%로 급락함(p<10^-100). WHERE는 래퍼가, HOW는 정책이 맡는다는 분업을 직접 확인한 실험임.
🧱 구성요소 Ablation: 고정 높이로만 운반하는 Naive transport는 55.5%p 향상분 중 29.5%p만 회복함(68.5%). Pre-contact set 제거가 가장 큰 하락(-18.6%p, 든 물체 789→708/800)을 만들었고, 경쟁 대상 제거(-8.6%p)는 목적지 도달을 785→737/800으로 떨어뜨림. Chunk commitment 제거는 -8.1%p, bounded transport 제거는 -6.9%p, hand-back 보조 제거는 -9.9%p로 모든 그룹이 유의미하게 기여함.
📊 개입 빈도와 파라미터 민감도: 운반 개입은 조합 에피소드의 83.9~96.5%에서 일어나고 원본 에피소드에서는 5.0~16.2%에 그침. 원본 1500개 에피소드 중 잘못된 바인딩 교정은 3건뿐임. 성공한 조합 에피소드에서 운반은 제어 스텝의 중앙값 14~15%를 차지하고, 상수·분위수 수준을 바꿔도 기본값과 유의한 차이가 없어 세밀한 튜닝 없이 공통 설정으로 동작함.
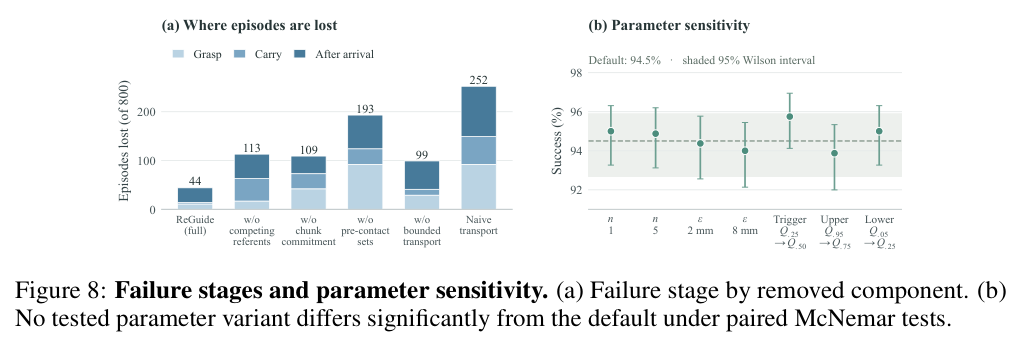
▲ Figure 8 · 구성요소 제거별 실패 단계와 파라미터 민감도 분석
⚡ 의의 및 실무 가치
🧭 VLA 실패를 '지식 부족'이 아닌 '바인딩 오류'로 재정의: 조합 일반화 실패를 데이터 커버리지나 재학습 문제로 보던 흐름과 달리, 실패를 WHERE(전역 그라운딩)와 HOW(로컬 조작)로 분해하고 WHERE만 고치면 된다는 점을 시뮬레이션 3개 백본과 실로봇에서 보여줌. 정책 가중치·디코딩을 건드리지 않고, 외부 플래너나 스코어러, 가이던스 가중치 튜닝 없이도 원본 성능을 유지함.
🏭 이미 배포된 VLA의 재학습 없는 현장 재배치, 물체·목적지가 수시로 바뀌는 물류·가정용 pick-and-place, 신규 물체 대응이 필요한 공장 셀에서 쓰일 학습 불필요 일반화 래퍼의 핵심 엔진!
🔗 원문 보기
Correcting WHERE, Preserving HOW: Compositional Generalization for Vision-Language-Action Models via Referential Guidance
- 📄 arXiv: https://arxiv.org/abs/2609.38616
- 📥 PDF: https://arxiv.org/pdf/2609.38616v1
- 👥 저자: Yanyan Zhang, Disheng Liu, Xinpeng Li, Chaoda Song, Mohsen Hariri, Debargha Ganguly 외 5명
- 📅 제출일: 2026-09-29 · cs.RO
'Vision-Language-Action > 논문리뷰' 카테고리의 다른 글
| 📝 [Memorize-Adapt-Ignore] 성공률을 넘어 표상 커널로: 데이터 변이 진단법 (0) | 2026.10.08 |
|---|---|
| 📝 [FVS] 승용차 VLA를 넘어 8등급 트럭으로: 229개 시나리오 적응 (0) | 2026.10.07 |
| 📝 [AD-Memo] 잠재 벡터를 넘어 언어로: 기억하는 자율주행 VLA (0) | 2026.10.07 |
| 📝 [DriftOPD] 청크 단위를 넘어 시퀀스로: 롤아웃 없는 1-step VLA 증류 (0) | 2026.10.07 |
| 📝 [Online-ES] 노이즈 가지치기를 넘어 궤적 진화로: Critic 없는 VLA 적응 (0) | 2026.10.07 |


댓글