한 줄 요약: 동결된 π0.5의 속도장을 공간 단서로 조향하는 초경량 어댑터로 신규 물체·지시 조작 성공률을 약 2배로 높임.
📦 배송 로봇은 "Joseph 이름이 적힌 포장 봉투 줘" 같은 자유로운 지시를 듣고, 처음 보는 물체를 집어야 함. 기존 이중 시스템(Dual-System)은 VLM이 지시를 시각 프롬프트로 바꾸고 기하 기반 제어기가 실행하는데, 인식이 흔들리거나 물체가 움직이면 쉽게 깨짐. 시각 프롬프트를 VLA 입력에 넣는 방식도 프롬프트가 행동 생성에 어떻게 반영되는지가 암묵적이라, 새로운 언어-물체 매핑에서는 엉뚱한 물체로 향하는 문제가 남아 있음.
이 논문은 "사전학습된 Flow-matching VLA는 이미 조작할 줄 알고 '무엇을' 집을지만 모를 뿐이므로, 공간 단서로 동결된 정책의 속도장을 아핀 변환으로 조향하면 새로운 언어-물체 매핑에도 일반화된다"는 원리를 증명함!
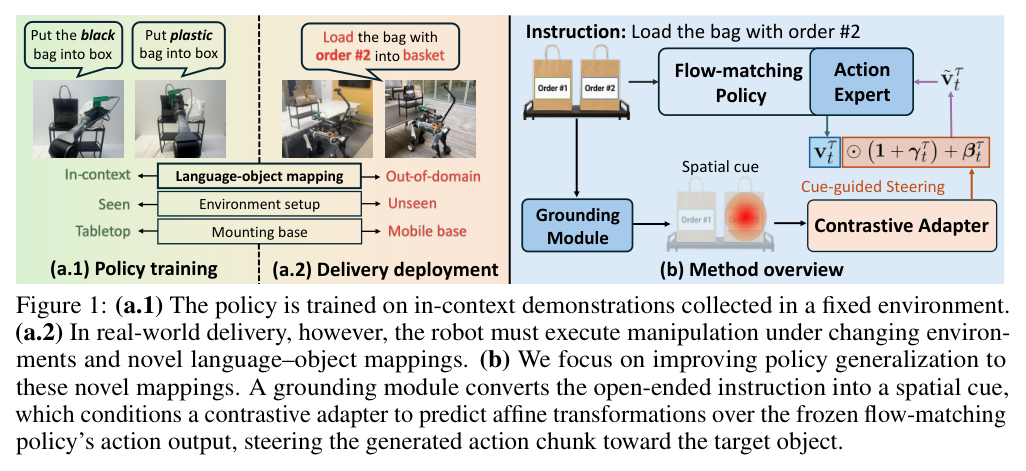
▲ Figure 1 · 고정 환경 학습과 개방형 배송 배포 사이의 간극, 그리고 공간 단서 기반 조향 파이프라인 개요
💡 핵심 기술 요약
🎯 Spatial Cue from System 2: Qwen3-VL-2B와 SAM2.1이 자유 지시를 목표 물체 중심의 가우시안 히트맵으로 바꿔, 이미지 프롬프트가 아닌 명시적 목표 지정 신호로 전달.
🧭 Velocity-level Diagonal Affine Steering: 동결된 π0.5 액션 전문가가 예측한 속도에 매 적분 스텝마다 스케일·시프트를 곱하고 더해 행동 청크를 목표 쪽으로 휘게 만듦.
🧲 Contrastive Cue Encoder: 공간 이동 네거티브와 잔차(Residual) 단서 대조 학습으로 장면 지름길 대신 '목표 위치'에 민감한 단서 표상을 학습, 파라미터 증가는 약 0.02%.
🔍 방법 자세히 보기
🧩 문제 정의: 새 기술이 아니라 '목표 지정'이 빠져 있음
같은 동결 정책이라도 학습 분포 안의 물체와 지시에서는 잘 작동하지만, 물체가 새것으로 바뀌고 지시 표현까지 바뀌면 어떤 물체에 손을 뻗어야 할지 결정하지 못함. 저자들은 뻗기·잡기·놓기라는 운동 기술 자체는 그대로라는 점에 주목해, 이를 새 조작 정책을 배우는 문제가 아닌 정책 조향(Policy Steering) 문제로 정의함. 즉 동결된 Flow-matching VLA와 외부 그라운딩 모듈이 준 공간 단서가 주어졌을 때, 기존 조작 사전지식(Prior)은 보존하면서 생성되는 행동 청크(Action Chunk)만 단서가 가리키는 목표로 돌리는 것이 목표임. 그래서 VLA 전체 파인튜닝 대신 가벼운 사이드카 어댑터만 학습하는 구조가 됨.
🛰️ System 2: 지시를 가우시안 히트맵 단서로 변환
입력은 자유 형식 사용자 지시와 작업 공간 카메라 영상임. 그라운딩 모델(Qwen3-VL-2B)이 목표 물체의 바운딩 박스를 예측하고, 세그멘테이션 모델(SAM2.1)이 이를 픽셀 단위 마스크로 바꿈. 마스크의 중심점(Centroid)을 구해 가우시안 히트맵을 만들고, 이 히트맵을 이미지 위에 덧그리는 시각 프롬프트가 아니라 별도의 명시적 공간 단서로 System 1에 넘김. System 2의 모든 구성요소는 동결된 채 제로샷으로 쓰이며, 롤아웃 시작 시 한 번만 호출되고 장면이 크게 바뀔 때만 다시 계산함. 궤적 전체를 그리는 조밀한 가이던스 대신 희소한 목표점만 요구하므로 고수준 플래너의 오류 부담이 줄어듦.
🌊 System 1: 속도장에 대각 아핀 변환을 거는 조향
System 1은 동결된 π0.5임. 노이즈 샘플에서 출발해 N 스텝에 걸쳐 실행 가능한 행동 청크로 적분해 가는데, 어댑터는 청크를 직접 수정하지 않고 각 적분 스텝에서 액션 전문가가 예측한 속도 v에 대해 '조향 속도 = v × (1 + γ) + β'를 적용함. γ와 β는 행동 차원 크기의 벡터로 청크의 모든 시간 위치에 브로드캐스트되며, γ는 원래 속도를 재가중하고 β는 단서에 따른 드리프트를 더함. 이 변환이 매 스텝 다시 예측되므로, 동결 정책이 조향된 중간 상태에서 다시 속도를 평가하며 궤적을 계속 다듬게 됨. 결과적으로 청크는 단서가 가리키는 목표로 향하면서도 사전학습된 흐름의 지배를 받아 자연스러운 조작 동작을 유지함.
🧲 Contrastive Adapter: 지름길 대신 단서 위치를 보게 만들기
단서는 관측 속 목표 물체와 정렬돼 있어서, 그냥 학습하면 어댑터가 학습 장면의 시각 패턴을 외우는 지름길(Shortcut)에 빠질 수 있음. 이를 막기 위해 단서 인코더와 예측 헤드로 어댑터를 구성함. 첫째, 공간 대조 손실(L_sp)은 액션 전문가 특징 기반 행동 표상이 정답 단서와는 가깝고, 같은 장면에서 히트맵 피크만 패치 격자 위로 옮긴 공간 이동 네거티브 및 배치 내 다른 단서와는 멀어지도록 학습시켜 외형이 아닌 위치에 민감하게 만듦. 둘째, 잔차 대조 손실(L_res)은 실제 히트맵 인코딩에서 빈(0) 히트맵 인코딩을 뺀 '단서가 만든 차이'만을 행동 표상과 정렬시켜, 행동 특징 자체에서 오는 지름길을 분리함.
🛠️ 학습 목표와 배포 방식
예측 헤드는 기본 정책과 동일한 Flow-matching 감독(L_flow)으로 γ, β를 학습해 사전학습 행동 분포를 유지하면서 조향을 배움. 과도한 보정을 막기 위해 γ와 β의 제곱 크기에 정규화 항(L_reg)을 걸고, 최종 손실은 L_flow에 L_sp, L_res, L_reg를 가중합한 형태임. 학습 데이터는 기본 정책을 파인튜닝한 같은 시연 데이터에 정답 공간 단서만 추가한 것임. 액션 전문가에 LoRA를 거는 대안도 시험했지만, 저데이터 환경에서 단서-행동 쌍에 과적합해 견고한 조향이 나오지 않았음. 배포 시에도 실제 히트맵과 0 히트맵의 잔차 특징으로 변조 항을 예측하며, 어댑터는 기본 정책 대비 약 0.02% 파라미터만 추가해 지연은 무시할 수준임.
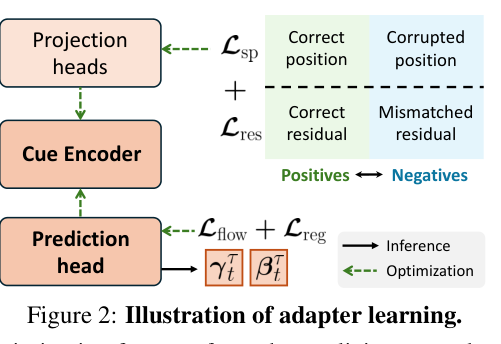
▲ Figure 2 · 단서 인코더의 공간·잔차 대조 학습과 아핀 변환 예측 헤드 구조
🧪 실험 설정
- 📚 학습 데이터: 검은 봉투와 비닐 봉투 2종(라벨 태그 없음)으로 수집한 시연 80개로 π0.5를 표준 레시피로 파인튜닝해 기본 정책으로 사용함. 시연은 모두 테이블탑에서 수집됨.
- 🤖 로봇/환경: 6-DoF 로봇 팔과 바퀴형 사족 로봇(DEEP Robotics LYNX M20)을 사용하고, 조작 단계에서는 베이스를 고정 자세에 둠. 전체 파이프라인이 RTX 5080 한 장에서 돌며 VLA는 15Hz로 연속 동작함.
- 🧪 평가 설정: Setting I(학습 물체+바꿔 말한 지시), II(새 물체+π0.5 어휘 안의 이름, 예: red bag), III(새 물체+새 지칭 표현, 예: bag with order number 1)로 구성. 과제마다 프롬프트 6개×공간 배치 2개를 테이블탑과 모바일 베이스에서 평가함.
- ⚖️ 비교 대상: 단일 프롬프트로 파인튜닝한 Base(π0.5), 다중 프롬프트로 언어 증강한 Base-L, 기하 기반 저수준 제어기를 쓰는 이중 시스템 MOKA, 시각 프롬프트를 π0.5 입력에 넣고 보조 그라운딩 목표로 학습하는 VP-VLA.
- 📏 평가 지표: 지시를 올바르게 완수했는지의 이진 성공률(%). 보조로 시뮬레이션 LIBERO-PRO Object-suite 과제 일반화 설정에서 200 에피소드 성공률을 측정함.
📊 주요 결과
🏆 테이블탑 평균 성공률 72.2%: Base 38.9%, VP-VLA 36.1%, Base-L 25.0%, MOKA 18.0% 대비 최고 성능으로, 최강 베이스라인 대비 상대 86% 향상(약 2배).
🛞 모바일 베이스에서도 63.9%: 시점·기하가 바뀌는 모바일 베이스에서 최강 베이스라인 VP-VLA(44.4%) 대비 상대 44% 향상. 모든 방법이 테이블탑보다 떨어졌지만 감소 폭은 72.2%→63.9%로 비교적 작음.
🆕 가장 어려운 Setting III에서 격차 극대화: 새 물체+새 지시 조건에서 테이블탑 66.7%(최강 베이스라인 Base-L 29.2%, Base 0.0%), 모바일 41.7%(베이스라인 최고 8.3%) 달성. Setting I·II에서도 두 플랫폼 모두 83.3%·66.7%로 최고 또는 공동 최고.
🖥️ LIBERO-PRO 시뮬레이션에서도 최고: Object-suite 과제 일반화 200 에피소드에서 15.5%로 Base 10.5%, Base-L 9.5%, VP-VLA 10.5%를 앞섬.
| Method | Tabletop Setting III (%) | Tabletop Avg (%) | Mobile Setting III (%) | Mobile Avg (%) |
|---|---|---|---|---|
| Base (π0.5) | 0.0 | 38.9 | 8.3 | 30.5 |
| Base-L | 29.2 | 25.0 | 8.3 | 5.5 |
| MOKA | 8.3 | 18.0 | 0.0 | 8.3 |
| VP-VLA | 4.2 | 36.1 | 8.3 | 44.4 |
| Ours | 66.7 | 72.2 | 41.7 | 63.9 |
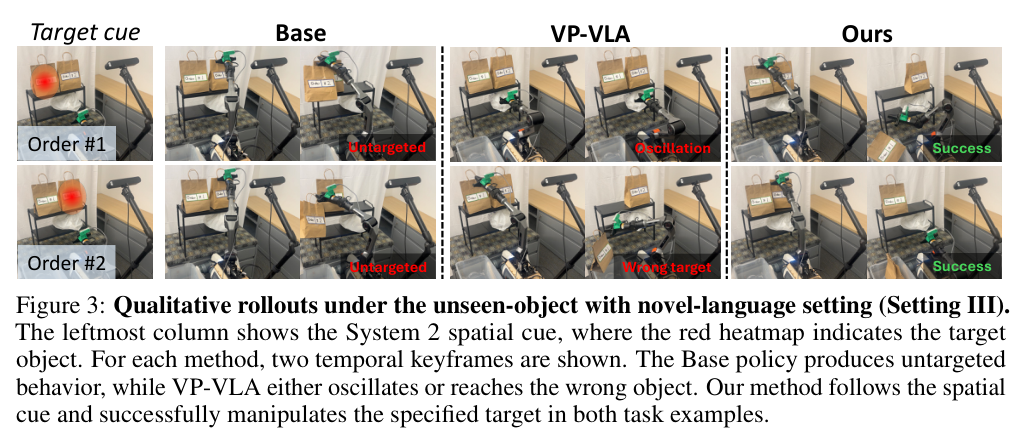
▲ Figure 3 · Setting III 롤아웃: Base는 목표 없이 움직이고 VP-VLA는 흔들리지만 제안법은 단서대로 성공
🔬 분석 & Ablation
🔬 구성요소 Ablation (모바일 Setting III): Base 8.3%에서 공간 단서 조건 어댑터만 붙이면 16.7%로 개선이 제한적임. 공간 대조 손실 L_sp를 추가하면 33.3%로 16.6%p 상승해 가장 큰 기여를 하고, 잔차 대조 손실 L_res까지 더하면 41.7%로 최고치 달성. 위치에 민감한 단서 표상 학습이 조향 성능의 핵심임을 보여줌.
🗺️ 공간 단서 형식 비교: 가우시안 히트맵과 패치 해상도의 이진 마스크는 비슷한 성능을 보여, 국소화된 목표 단서면 충분함. 반면 축 정렬 바운딩 박스는 경계가 거칠어 로봇을 잡을 수 없는 물체 영역으로 이끌 수 있어 성능이 더 낮음.
🎚️ 정규화 강도와 반응성: LIBERO-PRO에서 λ_reg를 0, 0.01, 0.03, 0.1로 바꾸면 성공률이 11.5%, 15.5%, 12.5%, 10.5%로, 정규화가 없으면 과보정하고 너무 강하면 유용한 조향을 억누름. 또한 단서를 시작 시 한 번만 계산해도 실행 중 목표 물체를 옮기면 VLA에서 물려받은 반응성으로 플래너 재호출 없이 따라감.
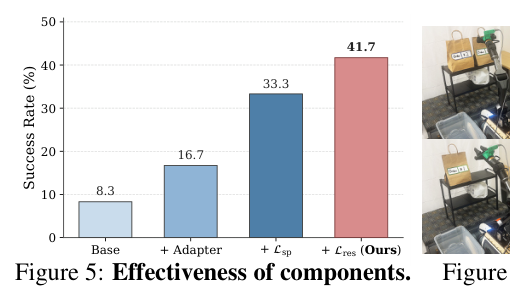
▲ Figure 5 · 어댑터·L_sp·L_res를 차례로 더할 때의 Setting III 성공률 변화
⚖️ 논문이 밝힌 한계
📍 기반 정책의 분포 밖 위치·어포던스에 민감: 방법이 밑바탕의 Flow-matching 정책에 의존하므로 분포 밖 어포던스 영역과 물체 위치에 여전히 취약함. 이 때문에 모바일 베이스의 정지 위치와 목표 대비 방향이 제약됨.
🚚 더 복잡한 배송 시나리오는 향후 과제: 사람과의 상호작용 및 직접 건네주기(Handover), 빽빽하게 쌓인 봉투 더미에서 물품 고르기, 내비게이션 정책과의 긴밀한 통합은 향후 연구로 남김. 현재 실험의 내비게이션은 수동으로 수행됨.
⚡ 의의 및 실무 가치
🔗 개방형 그라운딩과 반응형 VLA 제어를 잇는 인터페이스: 시각 프롬프트를 입력에 끼워 넣는 대신 동결 VLA의 속도장을 직접 조향하는 방식을 제시함. 기하 기반 제어기를 사전학습 VLA로 대체하면서도 전체 파인튜닝 없이 0.02% 파라미터로 새로운 언어-물체 매핑 일반화를 끌어올렸다는 점이 핵심임.
💼 라스트마일 배송 로봇, 서비스 로봇의 물품 픽업, 모바일 매니퓰레이터의 지시 기반 물체 집기, 단일 GPU 엣지 로봇 시스템을 위한 경량 정책 조향의 핵심 엔진!
🔗 원문 보기
Cue the Flow: Steering Flow-Matching Policies for Open-World Delivery Manipulation
- 📄 arXiv: https://arxiv.org/abs/2609.38989
- 📥 PDF: https://arxiv.org/pdf/2609.38989v1
- 🏠 프로젝트: https://hatchetproject.github.io/delivery_steer/
- 👥 저자: Haoxuan Wang, Griffin Galimi, Junhua Huang, Selina Song, Wayne Wu, Yan Yan 외 1명
- 📅 제출일: 2026-09-30 · cs.RO
'Vision-Language-Action > 논문리뷰' 카테고리의 다른 글
| 📝 [Online-ES] 노이즈 가지치기를 넘어 궤적 진화로: Critic 없는 VLA 적응 (0) | 2026.10.07 |
|---|---|
| 📝 [PRICE] 평가자 없이 결과만으로: 행동 청크별 크레딧 추론 (1) | 2026.10.06 |
| 📝 [Blackout vs. Freeze] 성공률 너머 물리적 위험으로: 카메라 고장 시 VLA 해부 (0) | 2026.10.06 |
| 📝 [UAO] 성능 경쟁을 넘어 보안으로: 3cm 공 하나로 VLA 무력화 (0) | 2026.10.06 |
| 📝 [DSDyn-VLA] 정적 VLA를 넘어 움직이는 세계로: Slow-Fast 이중 스트림 (0) | 2026.10.06 |


댓글