한 줄 요약: 광학 흐름·미래 상태 예측·RL 잔차 보정으로 움직이는 물체 조작 성공률을 끌어올린 VLA
🏭 🤖 VLA(Vision-Language-Action)는 이미지와 언어 지시를 받아 로봇 행동을 바로 출력하는 모델로, 빨래 개기나 커피 만들기 같은 정적 작업은 잘 해냄. 그런데 컨베이어 벨트 위 물체처럼 대상이 움직이면 금방 무너짐. 정지 RGB 이미지에는 속도 정보가 없고(Perception Gap), 추론 지연 동안 세상이 바뀌어 버리며(Latency Gap), 행동 청크(Action Chunk)를 개루프로 실행하는 동안에는 변화에 반응하지 못하기(Control Gap) 때문임.
이 논문은 "광학 흐름으로 움직임을 보고, 실행 시점의 상태를 미리 예측해 계획하며, 경량 RL 정책이 30Hz로 잔차를 보정하면 VLA가 움직이는 물체도 다룰 수 있다"는 원리를 증명함!
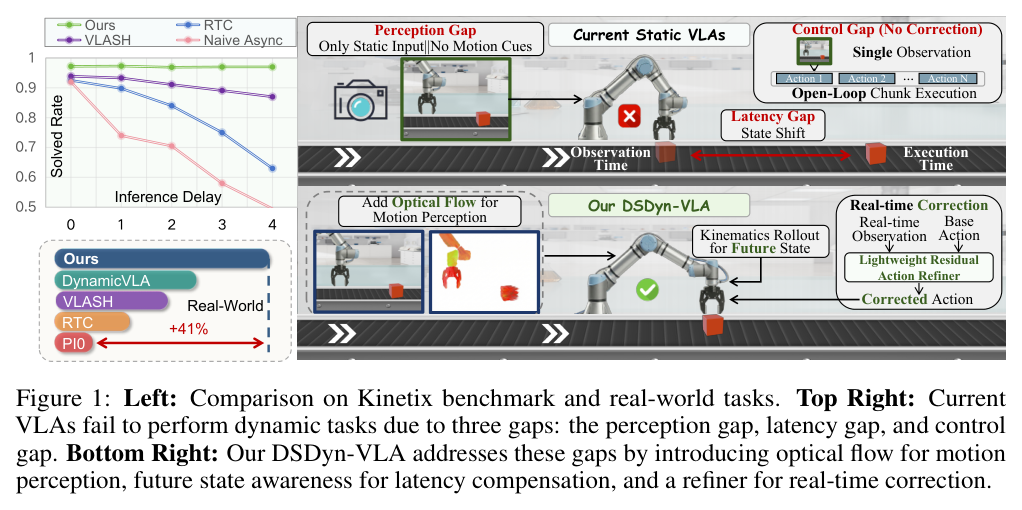
▲ Figure 1 · 동적 작업에서 VLA가 겪는 세 가지 Gap과 DSDyn-VLA의 해법
💡 핵심 기술 요약
🌊 Motion-Aware Perception: RAFT로 뽑은 광학 흐름(Optical Flow)을 극좌표 색상 이미지로 바꿔 별도 ViT에 넣고, RGB 토큰과 이어 붙여 VLA가 속도를 보게 함.
🔮 Future State Awareness: 추론 지연 동안 실행될 버퍼 행동을 Kinematics Rollout으로 굴려 실행 시점의 로봇 상태를 예측하고 그 상태 기준으로 행동 생성.
⚙️ Res-Refiner: RLPD로 학습한 경량 잔차 정책이 30Hz로 실시간 관측을 받아 청크 행동에 보정값을 더해 제어 루프를 닫음.
🔍 방법 자세히 보기
🧠 Slow-Fast 이중 스트림 구조
대뇌와 소뇌의 역할 분담에서 착안해 제어를 두 주파수로 나눔. 느린 스트림인 Flow-Planner는 PI0.5 기반 VLA로 약 2~3Hz에서 의미 추론과 행동 청크 생성을 맡고, 빠른 스트림인 Res-Refiner는 약 30Hz로 실시간 보정을 맡음. 최종 행동은 현재 시점에 해당하는 청크 행동(Macro-Plan)에 Res-Refiner가 내놓은 잔차(Reflex-Correction)를 더한 값임. 큰 모델은 전역적으로 일관된 계획을, 작은 모델은 청크 실행 중 생기는 오차 교정을 담당하도록 역할을 분리한 설계임.
🌈 광학 흐름을 CLIP 공간에 맞추는 Dual-Encoder
연속 프레임에서 RAFT-Large로 픽셀별 변위 벡터(u, v)를 추출함. 2채널 흐름장을 그대로 넣지 않고, 방향은 색상(Hue = atan2), 속도는 채도(벡터 크기)로 매핑한 3채널 RGB 형태 이미지로 변환함. 이렇게 하면 사전학습된 CLIP 계열 비전 인코더가 익숙한 색 공간에서 움직임을 해석할 수 있음. RGB 인코더는 '무엇인지', Flow 인코더는 '어떻게 움직이는지'를 뽑고, 두 출력 토큰을 시퀀스 방향으로 이어 붙여(2N개 토큰) VLA의 시각 컨텍스트로 사용하며 두 인코더 모두 end-to-end로 파인튜닝함.
⏩ Kinematics Rollout과 Time-Shift 학습
비동기 추론에서는 관측 시점보다 T_lat 스텝 뒤에 행동이 실행되므로 상태 불일치가 생김. 영상의 미래는 알 수 없지만 로봇 자신의 상태는 결정적이라는 점을 이용해, 추론 중 실행될 이전 청크의 버퍼 행동을 순기구학(Forward Kinematics)으로 굴려 실행 시점의 고유수용 상태(Proprioceptive State)를 계산하고 이를 VLA 조건으로 넣음. 학습 시에는 시각 관측은 t 시점, 고유수용 상태와 정답 행동 청크는 무작위로 뽑은 t+Δ 시점으로 짝지어 Conditional Flow Matching 손실로 학습함. 결과적으로 모델은 '과거 영상 + 미래 로봇 상태 → 미래 행동' 매핑을 배우고, 흔들리는 지연에도 강건해짐.
🎯 Res-Refiner 네트워크 설계
ResNet-10 백본 뒤에 학습 가능한 공간 임베딩(8개 spatial block)을 붙여 엔드이펙터와 물체의 공간 관계를 256차원 벡터로 압축함. 여러 카메라의 시각 특징, 현재 로봇 상태, Flow-Planner의 해당 스텝 행동을 이어 붙여 256 유닛 2층 MLP에 넣고, Tanh로 눌린 정규분포에서 잔차를 샘플링함. 잔차는 각 차원 행동 범위의 10%로 제한되어 큰 계획을 뒤엎지 않고 국소 보정만 수행함. 학습 중에는 ±4픽셀 랜덤 시프트(DrQ 방식) 증강으로 과적합을 막음.
🏋️ 2단계 학습: SFT 후 Residual RL
1단계에서는 동적 시연 데이터로 Flow-Planner를 Time-Shift 증강과 함께 CFM 손실로 지도학습함. 2단계에서는 Flow-Planner를 동결해 의미적 일반화 능력을 보존하고, Res-Refiner만 샘플 효율이 높은 RLPD로 학습함. 보상은 성공 여부 이진값(실세계는 사람이 수동 부여)이며, Replay Buffer는 오프라인 시연 50%와 온라인 경험 50%를 섞음. Q값 과대추정을 막기 위해 critic 앙상블의 최솟값으로 Bellman 타깃을 만들고, actor는 엔트로피 정규화와 함께 Q값을 최대화함. 실세계에서 RL 단계는 작업당 약 30~60분 소요됨.
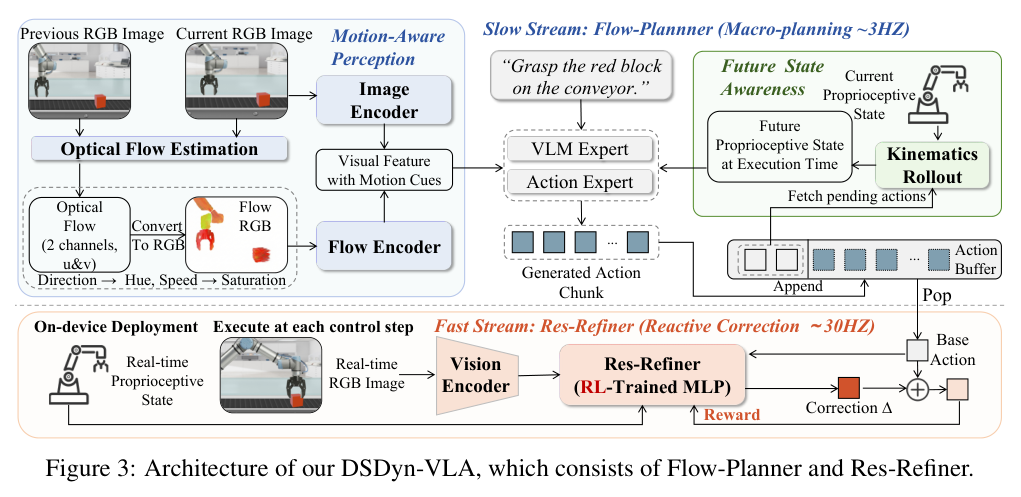
▲ Figure 3 · Flow-Planner(느린 스트림)와 Res-Refiner(빠른 스트림) 전체 구조
🧪 실험 설정
- 🎮 Kinetix 벤치마크: 동적 정책 평가용 상태 기반 시뮬레이션 12개 작업. Flow-Planner를 MLP 청크 정책(H=8)으로 바꾸고 광학 흐름은 생략, 지연 δ를 0~4 스텝으로 인위적으로 부여하며 설정당 2048회 시행.
- 🧪 DynBench (신규): MuJoCo 기반 Franka Panda 동적 조작 9개 작업(컨베이어 픽킹, 움직이는 구멍에 삽입, 굴러오는 공·캔 잡기, 빨강/초록 공 중 초록 고르기 등). 작업당 규칙 생성 시연 100개, 평가 100회.
- 🦾 실세계 로봇: 6-DOF Agilex Piper 팔 + Intel RealSense D435 카메라 2대. PI0.5 백본(청크 H=10), Res-Refiner 30Hz로 Conveyor Picking, Dynamic Dropping, Dynamic Stacking, Mobile Pouring 4개 작업을 5×50회 평가.
- ⚖️ 비교 대상: PI0.5, RTC(Real-Time Chunking), VLASH, DynamicVLA. Kinetix에서는 시각 기반인 DynamicVLA를 제외하고 RTC와 VLASH만 비교.
📊 주요 결과
🛡️ Kinetix 고지연에서도 97% 유지: 지연이 커질수록 RTC와 VLASH 성능이 빠르게 떨어지는 반면, DSDyn-VLA는 가장 심한 δ=4에서도 성공률 97% 이상을 유지함. 논문 기준 SOTA 대비 실패율을 13%에서 3%로 낮춰 76% 이상 감소시킴.
🦿 실세계 평균 성공률 49.0%: 4개 실세계 동적 작업 평균에서 PI0.5 8.4%, RTC 18.6%, VLASH 26.8%, DynamicVLA 38.1% 대비 49.0% 달성, PI0.5 대비 약 6배임. 특히 Dynamic Stacking은 PI0.5 1.2%에서 32.0%로 상승.
📊 DynBench 평균 48.4%: 9개 작업 평균 성공률 48.4%로 PI0.5(9.7%) 대비 약 5배, DynamicVLA(34.3%) 대비 14.1%p 높음. 9개 작업 모두에서 가장 높거나 공동 최고 성능 기록.
⏱️ 추가 모듈 연산 부담은 작음: RTX4090 기준 VLA 백본 73ms에 RAFT-Large 3ms, Flow 인코더 14ms, Kinematics Rollout 1ms 미만이 더해져 Flow-Planner 전체 103ms. Res-Refiner는 3ms에 불과함.
| Method | Conveyor Picking | Dynamic Stacking | Mobile Pouring | Average |
|---|---|---|---|---|
| PI0.5 | 8.8 ± 3.6 | 1.2 ± 1.8 | 8.8 ± 4.6 | 8.4 ± 3.6 |
| RTC | 12.4 ± 3.8 | 2.4 ± 2.6 | 16.0 ± 4.5 | 18.6 ± 4.1 |
| VLASH | 20.0 ± 4.5 | 6.8 ± 4.1 | 30.4 ± 5.7 | 26.8 ± 4.9 |
| DynamicVLA | 33.2 ± 5.4 | 18.0 ± 5.1 | 45.2 ± 6.1 | 38.1 ± 5.4 |
| DSDyn-VLA | 44.8 ± 4.1 | 32.0 ± 4.5 | 56.4 ± 5.7 | 49.0 ± 4.9 |
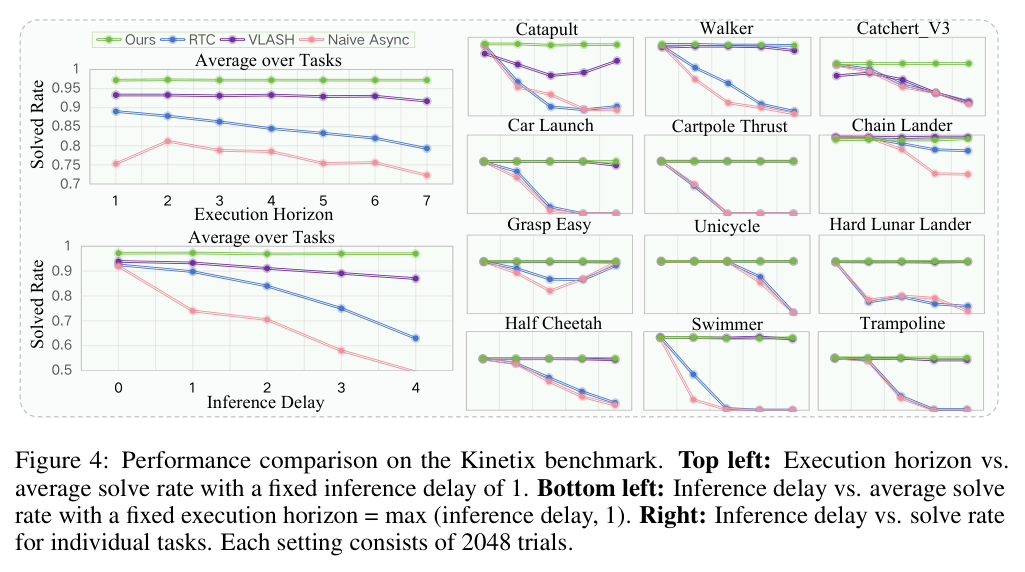
▲ Figure 4 · Kinetix에서 추론 지연·실행 구간별 성공률 비교
🔬 분석 & Ablation
🧩 세 모듈 모두 필수: 실세계 ablation에서 Full 48.5% 대비 광학 흐름 제거 시 30.5%, Future State Awareness 제거 시 36.5%, Res-Refiner 제거 시 25.0%로 하락함. Kinetix δ=4에서도 w/o Future 85.6%, w/o Refiner 87.0%로 각각 11.5%p, 10.1%p 떨어짐. DynBench에서는 Flow 제거(35.3%)가 Refiner·Future 제거(각 42.7%)보다 큰 타격을 줌.
🎨 Polar Map과 RL 학습 방식의 효과: 극좌표 색 매핑 대신 처음부터 학습한 ResNet-34로 흐름을 직접 토큰화하면 33.0%로 떨어져, CLIP 색 공간 정렬이 중요함을 보여줌. Res-Refiner를 RL 대신 SFT로 학습하면 37.5%에 그쳐, 시연 분포를 벗어난 상태에서의 복구는 RL이 있어야 학습됨.
🚀 잔차 학습이 처음부터 RL보다 쉬움: 같은 구조로 처음부터 RL을 학습한 정책 대비 Res-Refiner는 4.9배 빠르게 수렴하고 최고 성공률도 18% 높음. 저하된 광학 흐름 조건(70% 가림 42.0%, 깜빡이는 조명 40.5%)에서도 성능이 급락하지 않고 완만하게 떨어짐. 잔차를 행동 범위 10%로 제한해도 모든 차원이 범위의 95% 미만인 비율이 99.1%로, 포화는 드묾.
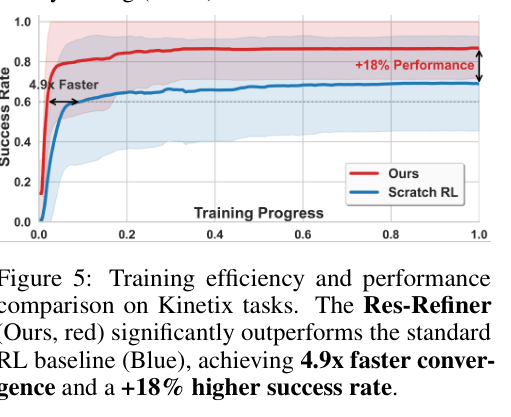
▲ Figure 5 · Res-Refiner와 처음부터 학습한 RL의 학습 곡선 비교
⚖️ 논문이 밝힌 한계
🔁 잔차 정책 일반화: Res-Refiner는 작업별 RL로 학습되며, 저자들은 잔차 정책의 일반화를 더 넓히는 것을 향후 과제로 밝힘.
🌐 실세계 평가 범위: 실세계 검증이 Piper 팔과 4개 작업에 한정되어, 더 많은 작업과 로봇 플랫폼으로 평가를 확장할 필요가 있다고 언급함.
⚠️ 사람과 공유하는 환경의 안전: 동적 환경으로 적용 범위가 넓어지는 만큼, 사람과 함께 쓰는 환경에서 안전과 실패 위험을 신중히 다뤄야 한다고 밝힘.
⚡ 의의 및 실무 가치
🧭 동적 조작 실패를 세 Gap으로 정리하고 한 프레임워크로 해결: 기존 실시간 VLA 연구(RTC, VLASH, DynamicVLA)가 지연 문제에 집중했다면, 이 연구는 인지·지연·제어 Gap을 각각 광학 흐름, 미래 상태 예측, RL 잔차 보정으로 함께 다룸. 9개 작업으로 된 DynBench를 공개해 동적 조작 정책을 체계적으로 평가할 기반도 마련함.
🏗️ 컨베이어 벨트 산업용 분류·피킹, 움직이는 용기에 담기와 따르기, 사람-로봇 물체 전달, 보조 로봇 같은 분야에서 움직이는 대상을 다루는 VLA의 핵심 엔진!
🔗 원문 보기
DSDyn-VLA: A Dual-Stream Dynamic Manipulation Framework with Motion Perception, Future Awareness, and Realtime Correction
- 📄 arXiv: https://arxiv.org/abs/2609.39198
- 📥 PDF: https://arxiv.org/pdf/2609.39198v1
- 👥 저자: Wenhao Li, Xiu Su, Yu Han, Yichao Cao, Shan You, Chang Xu
- 📅 제출일: 2026-09-30 · cs.RO
'Vision-Language-Action > 논문리뷰' 카테고리의 다른 글
| 📝 [Blackout vs. Freeze] 성공률 너머 물리적 위험으로: 카메라 고장 시 VLA 해부 (0) | 2026.10.06 |
|---|---|
| 📝 [UAO] 성능 경쟁을 넘어 보안으로: 3cm 공 하나로 VLA 무력화 (0) | 2026.10.06 |
| 📝 [Planning Limits of Latent WM] 더 큰 예측기 대신 목표 위치: 월드 모델 계획의 한계 (0) | 2026.10.05 |
| 📝 [MotionWeave] 미래 영상 복원 대신 움직임으로: 동작 중심 VLA (0) | 2026.10.05 |
| 📝 [IronMind] 리타게팅을 넘어 카메라 공간으로: 1만 시간 사람 영상 사전학습 (0) | 2026.10.05 |


댓글