한 줄 요약: 실행한 행동 이력을 Mamba로 기억해 초기 디노이징을 조종하고, 얼린 π0.5는 그대로 둠
🍎 VLA(Vision-Language-Action)는 카메라 영상과 언어 지시를 받아 로봇 행동을 바로 생성하는 모델임. π0.5 같은 대부분의 VLA는 현재 관찰만 보고 행동을 정해서, "사과를 저울 위에 든 상태"가 무게를 재기 전인지 후인지 구분하지 못하는 지각적 앨리어싱(Perceptual Aliasing) 문제를 겪음. 과거 프레임을 넣거나 메모리 모듈을 붙이는 기존 방식은 연산량이 크고, 무엇보다 기존 VLA까지 다시 학습시켜야 하는 부담이 있음.
이 논문은 "이미 실행한 행동 이력만 Mamba로 압축해 경량 PreAction Expert가 초기 고노이즈 디노이징을 조종하게 하면, 원래 VLA를 완전히 얼린 채 3.45% 파라미터 추가만으로 장기 작업의 단계 혼동을 크게 줄일 수 있다"는 원리를 증명함!
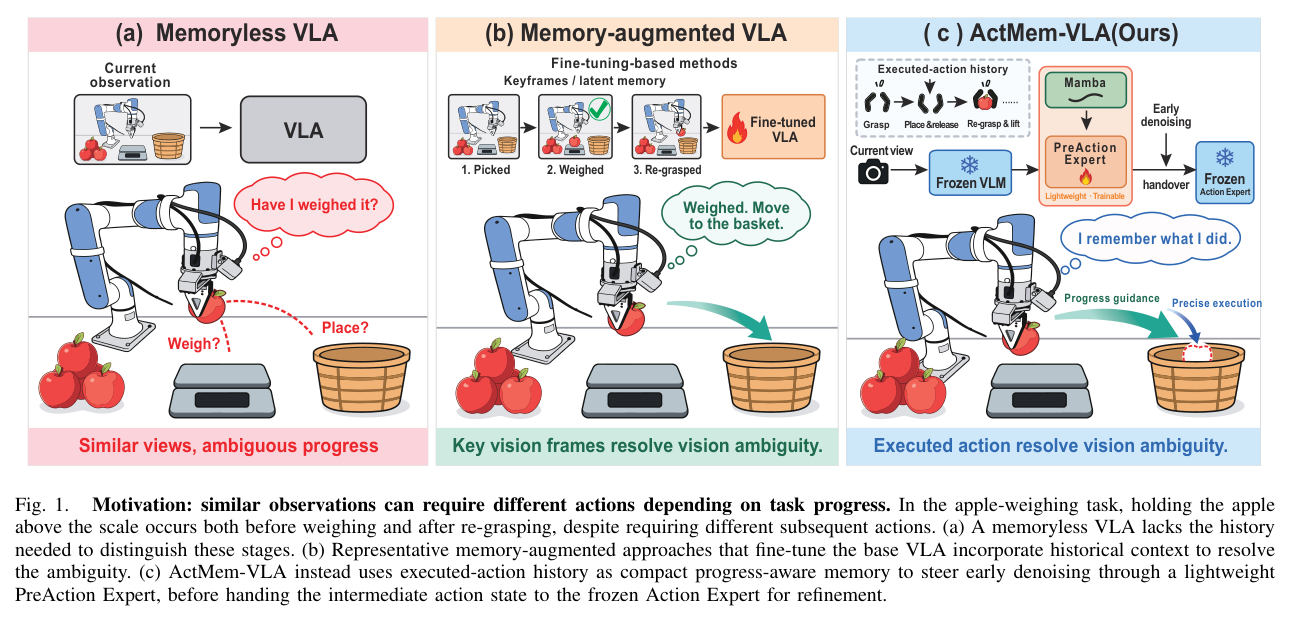
▲ Figure 1 · 같은 관찰이라도 진행 단계에 따라 다른 행동이 필요한 사과 계량 예시와 세 가지 접근 비교
💡 핵심 기술 요약
🧠 Mamba-based Execution Memory: 시각 정보 없이 실제 실행된 행동 블록만 Mamba-2로 재귀 압축해 작업 진행도를 담은 컴팩트한 메모리를 생성.
🔀 Dual-Expert Denoising Handover: 메모리 조건부 PAE가 초기 고노이즈 단계를 맡고, 중간 행동 상태를 얼린 Action Expert에 넘겨 저노이즈 정밀화를 수행.
🔌 Frozen Base-Policy Plug-in: VLM과 원래 AE는 전혀 건드리지 않고 Mamba와 PAE만 학습해, 3.45% 추가 파라미터로 기존 VLA에 기억을 이식.
🔍 방법 자세히 보기
🧩 문제 설정: 현재만 보는 flow-matching VLA의 맹점
π0.5 같은 flow-matching VLA는 현재 관찰을 조건으로 가우시안 노이즈를 n번의 Euler 업데이트로 점점 다듬어 H 길이의 행동 청크(Action Chunk)를 만들고, 그중 앞 s개를 실행한 뒤 다시 질의함. 문제는 작업이 현재 관찰 기준으로 비마르코프(Non-Markovian)라는 점임. 서로 다른 단계에서 거의 같은 관찰이 나타나도 이전에 실행한 행동 이력은 다른데, 기존 정책은 이 이력을 보지 않으므로 단계에 맞지 않는 행동을 고르거나 연속 질의 사이에서 두 행동을 오가게 됨. ActMem-VLA는 이 이력을 메모리로 바꿔 디노이징 과정 안에 주입하는 방식으로 해결함.
🗃️ Execution Memory: 관찰 대신 행동으로 기억하기
매 질의 시점마다 직전에 실행된 s개 행동 블록을 N층 Mamba-2 모듈에 넣고, 이전 재귀 상태와 함께 업데이트해 새 상태와 메모리 벡터(폭 d_m)를 얻음. 이 메모리는 다시 history key/value로 투영되어 PAE의 조건으로 쓰임. 시각 관찰을 배제한 이유는 고차원 이미지와 저차원 행동을 섞으면 모달리티 불균형이 생겨 중복된 시각 정보가 메모리를 지배하고, 진행도를 직접 반영하는 행동 동역학이 묻히기 때문임. 재귀 구조라 과거 프레임을 여러 장 처리하는 방식보다 계산 부담도 작음.
🎛️ PreAction Expert와 디노이징 핸드오버
PAE는 파인튜닝된 AE의 일부 층에서 복사한 P개의 Transformer 블록으로 초기화됨. 각 PAE 블록은 메모리에서 나온 history KV와, 현재 관찰·지시를 처리한 얼린 VLM 해당 층의 prefix KV를 함께 참조함. 추론 시 핸드오버 지점 r 이전(τ가 0에서 r까지)은 PAE가 속도장을 예측해 디노이징하고, τ=r에서 중간 행동 상태를 노이즈 재초기화 없이 그대로 얼린 AE에 넘겨 τ=1까지 마무리함. 기본값 r=0.4로 10스텝 중 4스텝은 PAE, 6스텝은 AE가 담당함. 전체 궤적의 큰 방향이 정해지는 초기 단계에서 기억 기반 조종을 하고, 세밀한 제어는 사전학습된 AE의 능력을 그대로 보존하려는 설계임.
🏋️ 학습: Mamba와 PAE만 함께 최적화
시연 에피소드에서 각 시점 이전의 행동으로 메모리를 계산하며, 추론과 똑같이 s-행동 블록 단위로 업데이트하고 불완전한 블록은 패딩함. 각 학습 질의마다 flow time τ를 [0, r] 구간에서만 샘플링해, 노이즈와 정답 행동을 섞은 노이즈 행동을 만들고 PAE가 예측한 속도장과 목표 속도(정답 행동 − 노이즈) 사이의 flow-matching 손실로 학습함. 즉 PAE는 자신이 맡는 고노이즈 구간만 학습함. VLM과 AE는 완전히 고정되므로 VLM의 prefix KV를 미리 계산해 재사용해 학습 속도를 높일 수 있음.
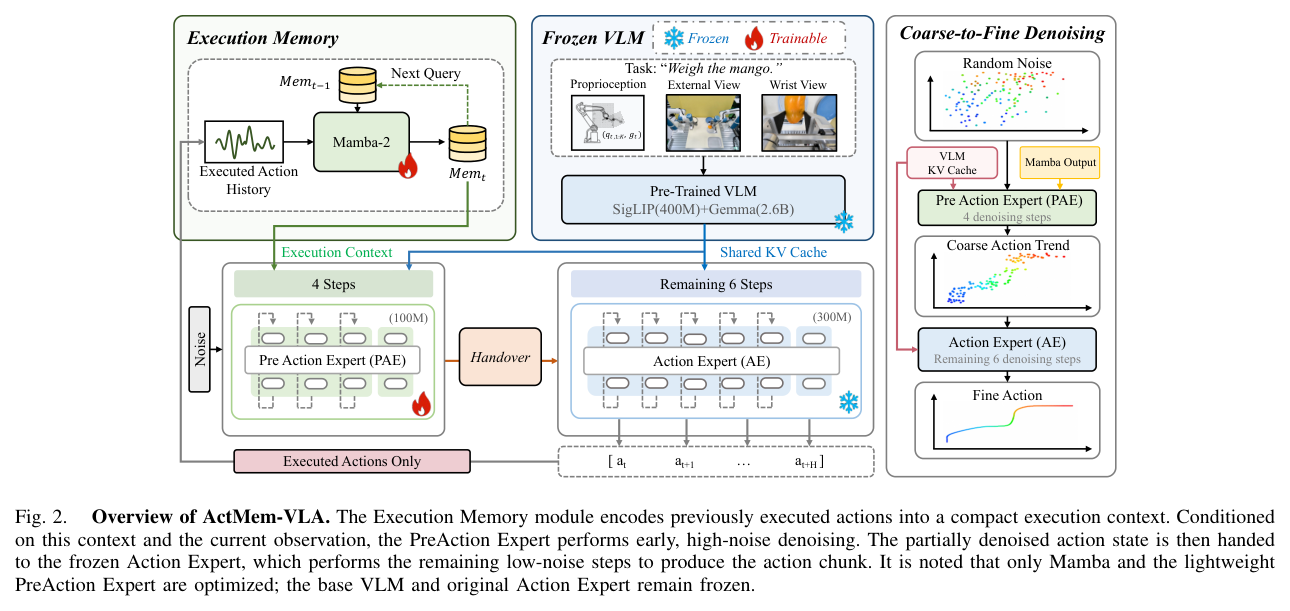
▲ Figure 2 · Execution Memory→PAE 초기 디노이징→얼린 AE 정밀화로 이어지는 전체 구조
🧪 실험 설정
- 🧪 벤치마크: 기억 의존적 조작 10개 과제(T1~T10)로 구성된 LIBERO-Mem 사용. 표준 600스텝 제한과 함께, 시연 길이 95퍼센타일을 20 단위로 올림한 과제별 스텝 제한도 적용함.
- 🦾 로봇/환경: 손목·머리 카메라를 단 DOBOT Nova 로봇팔, RTX5090 워크스테이션에서 ROS로 제어. 과제당 GELLO 텔레오퍼레이션으로 50개 시연 수집, R1~R4(두 번/세 번 그릇 반복, 망고 계량, 버튼 세 번 누르기) 4개 과제 평가.
- ⚖️ 비교 대상: 메모리 없는 π0.5, 과거 관찰 메모리 뱅크를 쓰는 MemoryVLA. 실세계에서는 π0.5와만 비교함.
- 📏 평가 지표: 성공률. 시뮬레이션은 학습 시드 3 × 평가 시드 3 × 20회로 과제당 180회, 실세계는 과제당 20회 시도.
📊 주요 결과
🏆 LIBERO-Mem 과제별 스텝 제한 평균 80.8%: 과제별 스텝 제한에서 평균 80.8%로 π0.5(65.2%) 대비 +15.6%p, MemoryVLA(49.5%) 대비 +31.3%p. 10개 중 6개 과제에서 최고, T7은 MemoryVLA와 동률이며 T1은 MemoryVLA, T9·T10은 π0.5가 앞섬.
📈 T3~T6에서 두드러진 이득: T4에서 85.6%로 π0.5(40.0%), MemoryVLA(20.0%)를 크게 앞섰고, T5에서는 95.0%로 MemoryVLA(3.3%)와 큰 격차를 보임.
🔁 표준 600스텝 기준의 한계 발견: 표준 600스텝 기준에서도 동등 이상이고 T6에서 크게 앞서지만, 메모리 없는 π0.5도 T1~T3에서 거의 100%를 달성함. 순환 행동만으로 성공 조건을 채울 수 있어 이 기준으로는 메모리 활용 여부가 드러나지 않음.
🌍 실세계 4개 과제 평균 +28.8%p: π0.5 대비 R1 85→100%, R2 10→65%, R3 15→35%, R4 30→55%로 모든 과제에서 향상, 총 28/80에서 51/80 성공(평균 35.0%→63.75%). 계량 전후 구분이 필요한 R2에서 가장 큰 향상.
| 과제 | π0.5 | ActMem-VLA |
|---|---|---|
| R1 Two-Cycle Bowl Return | 85 | 100 |
| R2 Mango Weighing | 10 | 65 |
| R3 Triple Button Press | 15 | 35 |
| R4 Three-Cycle Bowl Return | 30 | 55 |
| 평균 | 35.0 | 63.75 |

▲ Figure 4 · LIBERO-Mem 과제별 스텝 제한에서 T1~T10 성공률 비교
🔬 분석 & Ablation
🔬 구성요소 Ablation (T6~T8): Execution Memory를 빼면 평균 55.0%→40.6%, PAE를 빼고 얼린 AE에 메모리를 직접 조건화하면 53.3%로 하락. 7회 반복 과제 T6에서 특히 커서 80.0%→38.3%(메모리 제거), 58.3%(PAE 제거)로 떨어짐. 반면 물체 재배치 과제 T8에서는 두 변형이 각각 50.0%, 63.3%로 전체 모델(45.0%)보다 높아, 이득이 과제 의존적임을 보여줌.
⏱️ 핸드오버 지점 r: r=0.3/0.4/0.5/0.6에서 평균 48.3/55.0/45.0/47.2%로, r=0.4가 세 과제 모두 최고. r이 작으면 기억 기반 디노이징 스텝이 부족하고, 크면 얼린 AE의 정밀화 스텝이 부족해져 중간 배분(PAE 4스텝+AE 6스텝)이 가장 적절함.
📦 용량을 키운다고 좋아지지 않음: Mamba 깊이 2→4에서 평균 43.3%로 하락, 폭 1024→1536은 55.6%로 +0.6%p에 그쳐 기본값 유지. PAE 깊이 4→2는 43.9%, 4→6은 53.9%로 4층이 최적이며, 모델 크기 증가가 일관된 향상으로 이어지지 않음.
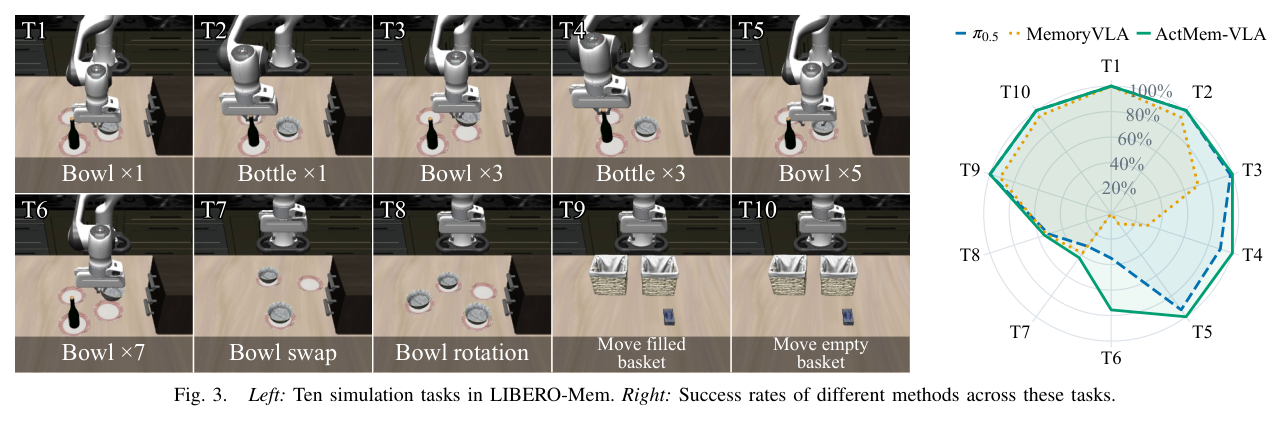
▲ Figure 3 · LIBERO-Mem 10개 과제와 표준 600스텝 기준 방법별 성공률 레이더 차트
⚖️ 논문이 밝힌 한계
🧩 과제 의존적인 구성요소 효과: 반복 추적 과제에서는 이득이 크지만 T8 같은 다단계 물체 재배치에서는 구성요소를 뺀 변형이 더 높아, 재배치 과제에서는 결과가 혼재됨을 논문이 직접 밝힘.
🔂 세 번 반복 과제는 여전히 어려움: 실세계에서 두 번 반복 R1은 100%지만 세 번 반복 R3(35%), R4(55%)는 여전히 신뢰성 있는 수행이 어려움.
📐 기존 벤치마크 성공 기준의 한계: LIBERO-Mem 표준 600스텝 기준은 순환 행동으로도 성공 판정이 가능해 메모리 활용을 제대로 드러내지 못하므로, 과제별 스텝 제한을 별도로 도입해야 했음.
🚀 의의 및 실무 가치
🔓 기억 학습과 정책 정밀화의 분리: 하나의 디노이징 궤적을 학습 가능한 기억 기반 조종과 얼린 정책 정밀화로 나눠, 이미 파인튜닝된 VLA를 재학습하지 않고도 시간적 기억을 붙이는 플러그 앤 플레이 경로를 제시함. 무거운 시각 이력 대신 행동 이력만으로도 단계 구분이 가능함을 보여줌.
🏭 반복 횟수 세기가 필요한 조립·포장 라인, 계량·검사처럼 전후 상태가 비슷한 물류 작업, 이미 배포된 VLA에 저비용으로 기억을 추가하는 현장 적용의 핵심 엔진!
🔗 원문 보기
Remember What You Did: Action-History Memory with Dual-Expert Denoising for Long-Horizon Vision-Language-Action Policies
- 📄 arXiv: https://arxiv.org/abs/2609.37307
- 📥 PDF: https://arxiv.org/pdf/2609.37307v1
- 👥 저자: Yaxin Zhao, Dianye Huang, Chenwei Wang, Chenguang Yang, Zhongliang Jiang
- 📅 제출일: 2026-09-29 · cs.RO
'Vision-Language-Action > 논문리뷰' 카테고리의 다른 글
| 📝 [EgoHumanoid-V2] 분리 제어를 넘어 전신 협응으로: 사람 시연만으로 휴머노이드 학습 (0) | 2026.10.01 |
|---|---|
| 📝 [V-JEPA Policy] 비디오 생성기 없이 예측 잠재 공간으로: 0.9B 월드-액션 모델 (0) | 2026.10.01 |
| 📝 [Self-Compensating VLA] 명령-실행 오차를 넘어 자가 보정으로: 배포 중 적응하는 VLA (0) | 2026.10.01 |
| 📝 [RawVLA] 고정 ISP를 넘어 RAW로: 행동을 위한 신경 ISP (0) | 2026.10.01 |
| 📝 [Faster and Better?] 성공률을 넘어 궤적으로: VLA 가속 평가 버그 감사 (0) | 2026.10.01 |


댓글