한 줄 요약: VLA 가속 기법의 성공률 상승은 벤치마크 버그와 설계 한계가 만든 착시일 수 있음을 7개 벤치마크 감사로 보여줌
🔍 VLA(Vision-Language-Action) 모델은 카메라 영상과 언어 지시를 받아 로봇 행동을 출력하는 모델이고, 실제 로봇에 올리려면 추론 지연(Latency)을 줄이는 가속 기법이 꼭 필요함. 가속 기법은 보통 "속도는 빨라졌고, 시뮬레이션 벤치마크 성공률은 떨어지지 않았다"는 방식으로 검증됨. 그런데 원래 정책의 계산을 근사만 하는 Training-free 가속 기법이 오히려 원본보다 높은 성공률을 내는 이상 현상이 나타남. 성공률 숫자만으로는 이것이 실제로 더 잘 수행한 결과인지, 성공 판정기(Success Checker)의 결함 때문인지 구분할 수 없음.
이 논문은 "VLA 가속 기법이 원본보다 높게 받은 성공률은 벤치마크 버그와 설계 한계가 만든 착시일 수 있으며, 이를 고치면 방법 간 순위까지 뒤집힌다"는 것을 보여줌!
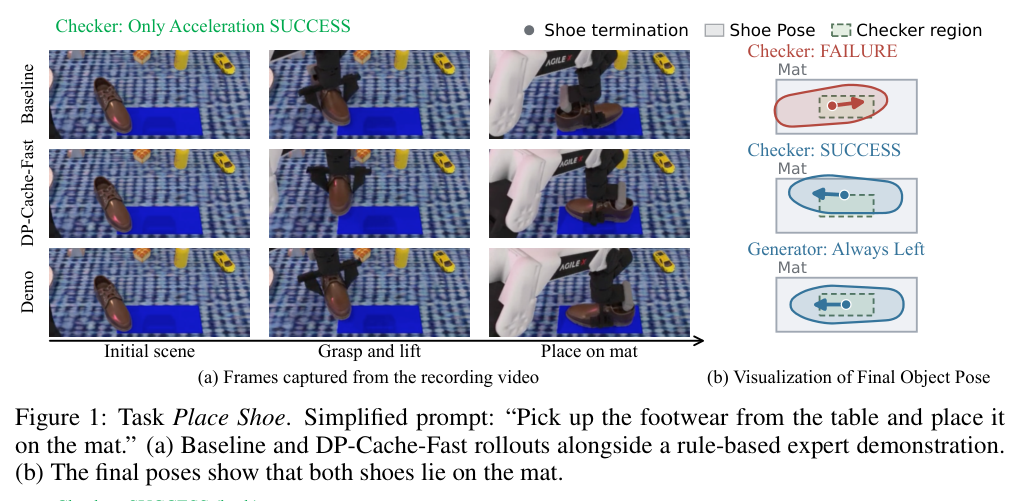
▲ Figure 1 · Place Shoe에서 둘 다 매트 위에 올렸는데 Baseline만 실패 판정받은 사례
💡 핵심 기술 요약
🗺️ Trajectory & Acceptance-Region Visualization: 물체·엔드이펙터 궤적을 판정기 수용 영역 위에 그려서 영상 녹화 오버헤드(약 85%) 없이 판정 오류를 찾아냄.
🐞 Benchmark Bug Taxonomy: 7개 벤치마크에서 찾은 버그 22개를 Task Consistency, Initialization, Reproducibility 세 범주로 분류하고 수정함.
⚖️ Design Limitation Revision: 허술한 판정기를 보강하고, 비현실적인 물체 질량을 고치고, 부드러운 행동에 점수를 더 주는 Motion-aware Score를 추가함.
🔍 방법 자세히 보기
🚩 이상 이득의 두 가지 패턴: False Failure vs False Success
출발점은 DP-Cache, ProbeFlow 같은 Training-free 가속 기법이 π0.5 Baseline보다 높은 성공률을 받은 태스크들임. 들여다보니 두 가지 패턴이 나옴. 첫째는 거짓 Baseline 실패(False Baseline Failure)임. Place Shoe에서는 지시문에 없는 신발 앞코 방향을 판정기가 요구해서, 오른쪽을 향하게 놓은 Baseline은 떨어지고 데모 방향(왼쪽)을 따라 한 DP-Cache-Fast는 통과함. 둘째는 거짓 가속 성공(False Acceleration Success)임. Put Bottles Dustbin에서 DP-Cache-Slow는 병을 잡지도 않고 쳐서 떨어뜨렸는데, 병이 굴러 수용 영역에 들어가자 성공으로 기록됨.
🗺️ 결함 위치 찾기 워크플로 (Audit Workflow)
먼저 Baseline 실행과 가속 실행이 정말 같은 태스크 인스턴스와 같은 평가 설정을 썼는지 확인하고, 초기화나 재현성 불일치가 있으면 그것부터 조사함. 조건이 맞는데 결과가 다르면, 로그에 남은 물체·엔드이펙터 궤적과 그리퍼 상태를 판정기 수용 영역 위에 그리고 성공이 판정된 시점을 표시함. 이 그림을 지시문, 데모, 코드와 대조하고, 의심되는 결함은 도메인 전문가가 직접 검증함. 모든 에피소드를 녹화하면 시간이 에피소드당 86.4초에서 160.4초로 늘어나서, 궤적 그림에서 문제가 보인 경우에만 영상을 확인함. 이렇게 찾은 결함은 같은 템플릿·로더·판정기를 공유하는 태스크와 다른 벤치마크의 같은 역할 구성요소로 넓혀서 다시 점검하며, 이상 이득이 없던 태스크도 포함함.
🐞 버그 3분류: 일관성·초기화·재현성
Task Consistency 버그는 지시문, 판정기, 데모가 서로 다른 요구를 하는 경우임. 예를 들어 Handover Block은 지시문이 "왼팔로 빨간 블록을 잡아라"뿐인데 판정기는 오른팔에 건네서 패드에 내려놓아야 성공으로 봄. VLABench Select Painting은 그림을 잡으라고 지시하는데 데모는 버튼을 누름. Initialization 버그는 잘못된 프롬프트나 잘못된 초기 상태가 들어가는 경우임. LIBERO-PRO는 "스토브를 켜라"는 프롬프트를 주면서 판정기는 꺼진 상태를 요구하고, RoboCasa는 출발지와 목적지가 같은 물체로 잡혀서 시작하자마자 성공 상태가 되기도 함. Reproducibility 버그는 시드를 같게 줘도 조건이 달라지는 경우로, RoboTwin은 시드가 지시문 샘플링을 제어하지 못하고, LIBERO는 MuJoCo 버전이 고정되어 있지 않음.
📏 허술한 판정기와 고정 임계값 보강
결과만 보는 판정기에는 과정 확인 조건을 더함. Put Bottles Dustbin에는 병이 떨어지기 전 일정 시간 안에 그리퍼가 쓰레기통 위에 있어야 한다는 조건을 넣었고, VLABench Select Drink에는 음료를 떨어뜨리지 않고 통제된 상태로 꺼냈는지 확인하는 조건을 넣음. Scan Object에서는 DP-Cache-Fast의 축 방향 거리 분산이 Baseline의 11.8배, 횡방향 오차 분산이 4.5배로 공간 분포 자체가 달랐음. 그래서 수용 영역을 정하는 파라미터를 여러 값으로 바꿔 가며 재평가하고, 순위가 임계값 선택에 얼마나 민감한지 확인함.
🏋️ Sim-to-Real 보정: 물체 질량과 Motion-aware Score
RoboTwin에서 동적 물체를 만드는 코드의 60% 이상이 기본 질량 10 g을 쓰고, Beat Block Hammer의 망치는 실제로 600 g인데 1 g으로 설정되어 있음. LIBERO와 RoboCasa는 충돌 형상에 밀도 100 kg/m³를 곱해 질량을 계산해서, 실제 150 g인 접시가 11.52 g이 됨. 논문은 이런 질량을 현실적인 값으로 고쳐 재평가하고, 고친 질량으로 재학습도 해봄. 행동 품질도 따로 봄. 시뮬레이션은 TOPP 리타이밍으로 가속 기법이 만든 떨림(Jitter)이 가려지기 때문에, 후처리 전 정책 출력의 행동 변동량으로 에피소드마다 네 방법의 순위를 매기고 순위에 따라 점수를 줌. 실패한 롤아웃은 0점임.
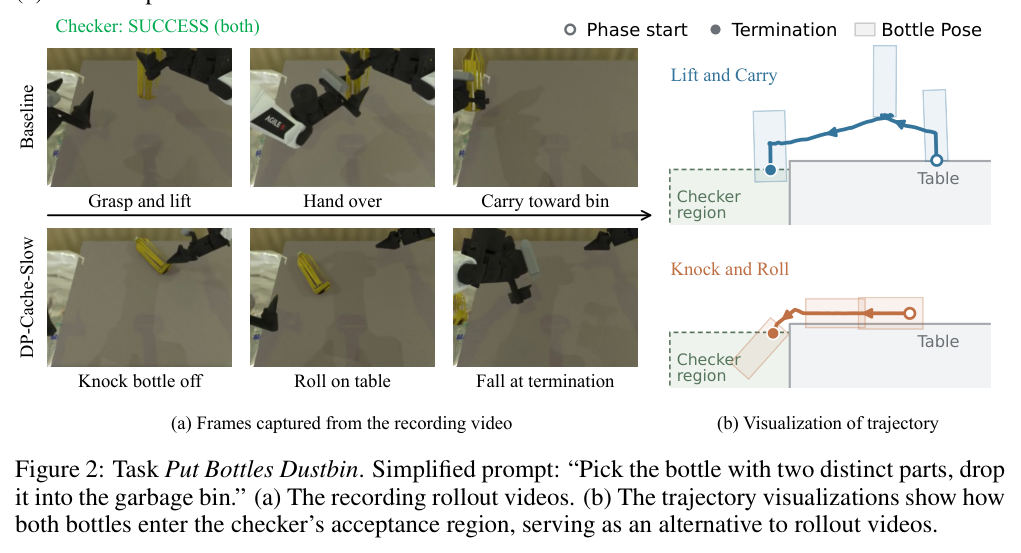
▲ Figure 2 · 병을 쳐서 떨어뜨렸는데 수용 영역에 굴러 들어가 성공 처리된 궤적 시각화
🧪 실험 설정
- 🧪 벤치마크: LIBERO, LIBERO-PRO, LIBERO-Plus, RoboTwin 2.0, RoboCasa, VLABench, RoboDojo까지 7개를 감사함. 수치 재평가는 RoboTwin, VLABench, LIBERO(-PRO)의 일부 태스크에서 진행함.
- 🤖 정책 모델 / 하드웨어: 커뮤니티가 공개한 π0.5 체크포인트를 NVIDIA A800과 RTX 4090 GPU에서 돌림. Pick Dual Bottles 태스크는 실제 로봇에서도 비교함.
- ⚡ 비교 대상 (가속 기법): DP-Cache-Fast(S=5, 2.56배 가속), DP-Cache-Slow(S=2, 1.62배), ProbeFlow(ε=0.008, 1.49배)를 가속 없는 Baseline과 비교함.
- 📊 평가 지표: 수정 전후 성공률(SR)과 Baseline 대비 차이를 봄. Motion-aware 평가를 한 태스크는 성공률 대신 순위 기반 점수를 보고함.
📊 주요 결과
🔄 버그만 고쳐도 순위가 뒤집힘: LIBERO-PRO Spatial-Task에서 Baseline 성공률이 0.4%에서 53.2%로 올라 꼴찌에서 1위가 됨. RoboTwin Rotate QRCode에서도 ProbeFlow보다 3%p 뒤지던 Baseline이 6%p 앞서게 됨.
📈 1위는 같아도 격차가 벌어짐: VLABench Select Mahjong에서 버그를 고치자 Baseline은 17%p 올랐고 가속 기법들은 6~10%p 오르는 데 그침. Select Painting에서는 Baseline이 13%p 오름.
🚮 판정기를 보강하자 가속 이득이 사라짐: Put Bottles Dustbin에서 Baseline은 24%로 그대로였고 DP-Cache-Slow는 28%에서 22%로 떨어짐. Select Drink에서는 ProbeFlow가 19%에서 9%로 떨어져 Baseline과의 격차가 16%p에서 22%p로 벌어짐.
⚖️ 질량 보정과 부드러움 점수로 역전: Place Fan에서 질량을 고치자 DP-Cache-Fast가 61%에서 33%로 떨어져, 21%p 뒤지던 Baseline(38%)이 5%p 앞서게 됨. 고친 질량으로 재학습한 Baseline은 53%까지 올라감. Scan Object에 Motion-aware 점수를 적용하자 Baseline은 ProbeFlow보다 5%p 뒤지다가 16.6점 앞서게 됨.
| 태스크 (수정 유형) | Baseline | DP-Cache-Fast | DP-Cache-Slow | ProbeFlow |
|---|---|---|---|---|
| RoboTwin place shoe (버그) | 65 / 74 | 68 / 69 | 66 / 67 | 68 / 69 |
| RoboTwin rotate qrcode (버그) | 56 / 66 | 60 / 62 | 48 / 57 | 59 / 60 |
| LIBERO-PRO Spatial-Task (버그) | 0.4 / 53.2 | 0.4 / 52.8 | 0.6 / 52.2 | 0.6 / 52.2 |
| VLABench select mahjong (버그) | 18 / 35 | 7 / 17 | 14 / 20 | 8 / 17 |
| RoboTwin place fan (질량) | 40 / 38 | 61 / 33 | 51 / 38 | 59 / 34 |
| RoboTwin scan object (Motion-aware) | 31 / 31.0 | 34 / 20.0 | 35 / 28.0 | 36 / 14.4 |
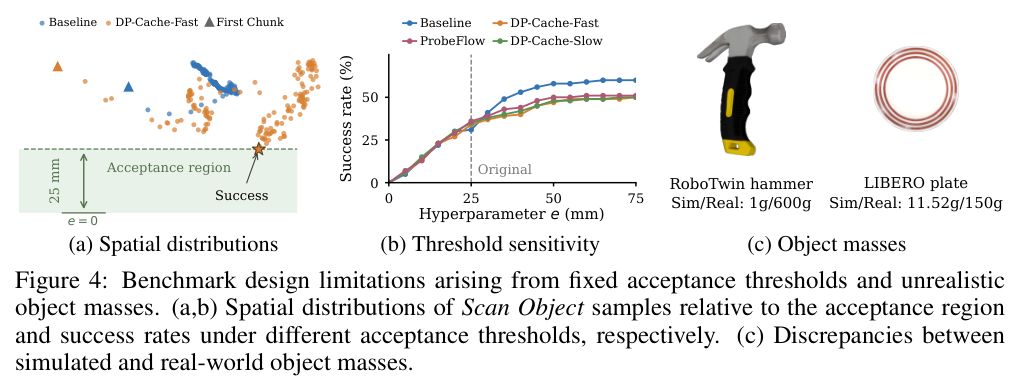
▲ Figure 4 · 수용 임계값과 물체 질량 설정에 따라 성공률이 흔들리는 모습
🔬 분석 & Ablation
🎯 수용 임계값에 따라 순위가 바뀜: Scan Object에서 횡방향 허용 오차 e만 바꿔 봄. 25 mm보다 작으면 방법 간 성공률이 비슷했고, 25 mm에서는 Baseline이 ProbeFlow보다 5%p 뒤졌음(31% vs 36%). 50 mm에서는 Baseline이 8%p 앞섬(58% vs 50%). 임계값 하나로만 평가하면 순위가 하이퍼파라미터 선택에 따라 달라질 수 있다는 뜻임.
🦾 시뮬레이션의 부드러움은 실제 로봇으로 이어지지 않음: Pick Dual Bottles 시뮬레이션에서 DP-Cache-Slow와 ProbeFlow는 정책 출력의 Jerk가 Baseline의 1.45배, 2.16배였음. 그런데 실제로 실행된 Jerk는 0.94배, 0.92배로 오히려 작게 나옴. 실제 로봇에서는 실행 Jerk 비율이 1.35배, 1.43배로 올라감. TOPP 리타이밍, 제어 주파수 한계, 저수준 모터 제어 방식의 차이가 원인으로 꼽혔고, 그래서 후처리 전 행동 변동량을 보조 순위 기준으로 씀.
🔨 질량 보정이 성공률에 미치는 영향: Beat Block Hammer에서 망치 질량을 현실 값으로 고치자 Baseline 성공률이 79%에서 27%로, DP-Cache-Fast가 87%에서 19%로 떨어짐. LIBERO Mug Placement in Microwave도 94%에서 60%로 떨어짐. 비현실적으로 가벼운 물체 때문에 시뮬레이션 성공률이 부풀려져 있었고, 가속 기법이 받던 이득도 그 부풀린 부분에서 나왔을 수 있음.
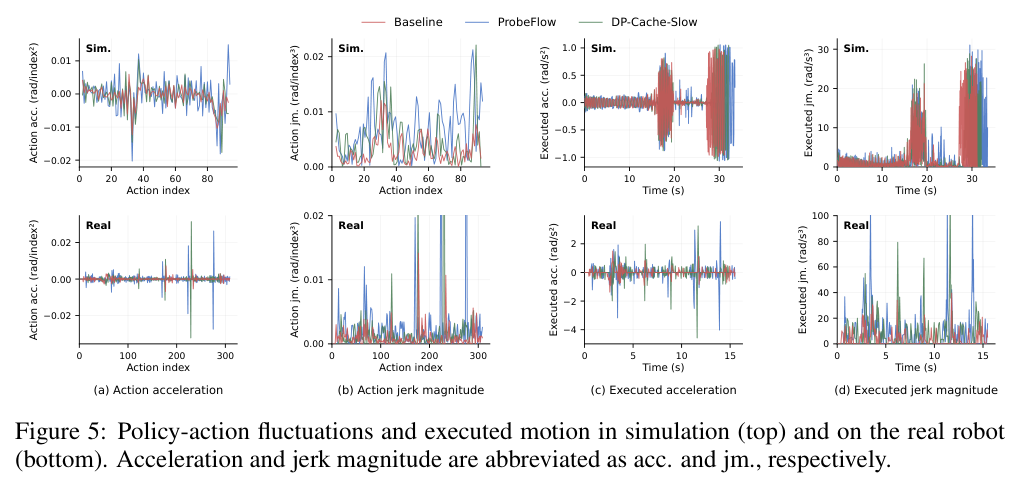
▲ Figure 5 · 시뮬레이션과 실제 로봇에서 정책 출력 변동과 실행 모션 비교
⚖️ 논문이 밝힌 한계
🔭 새 벤치마크에 대한 감사와 수정 반영은 진행 중: 이번 감사는 7개 벤치마크까지만 다룸. 저자들은 새로 나오는 벤치마크의 결함도 계속 조사하고, 각 벤치마크에 보낸 수정 Pull Request가 반영되는지 추적하겠다고 밝힘.
🧭 의의 및 실무 가치
🏛️ 성공률 하나에 기대던 가속 평가 관행에 대한 반례: "빨라졌는데 성공률도 올랐다"는 결과가 벤치마크 결함의 산물일 수 있음을 버그 22개와 설계 한계 4개로 보여줌. 이를 고치면 순위까지 뒤집힘. 수정 사항과 수정한 벤치마크 설정을 공개해서, 같은 정책의 가속 변형들을 공정하게 비교할 기반을 마련함.
💻 VLA 추론 가속 연구의 검증, 로봇 조작 벤치마크의 유지보수와 QA, 실제 로봇 배포 전 Sim-to-Real 점검에 쓸 수 있는 신뢰할 수 있는 평가 파이프라인의 핵심 엔진!
🔗 원문 보기
Faster and Better? Benchmark Bugs and Design Limitations Distort the Evaluation of Vision-Language-Action Acceleration
- 📄 arXiv: https://arxiv.org/abs/2609.37771
- 📥 PDF: https://arxiv.org/pdf/2609.37771v1
- 👥 저자: Qiwei Chen, Kaijun Zhou, Nuohui Shi, Zhiyang Li, Yuxuan Feng, Jinyu Gu
- 📅 제출일: 2026-09-29 · cs.RO
'Vision-Language-Action > 논문리뷰' 카테고리의 다른 글
| 📝 [Self-Compensating VLA] 명령-실행 오차를 넘어 자가 보정으로: 배포 중 적응하는 VLA (0) | 2026.10.01 |
|---|---|
| 📝 [RawVLA] 고정 ISP를 넘어 RAW로: 행동을 위한 신경 ISP (0) | 2026.10.01 |
| 📝 [UAD] 균일 디노이징을 넘어 긴급도 순으로: 급한 행동부터 먼저 내보내기 (0) | 2026.10.01 |
| 📝 [RoboSkill] 매번 처음부터를 넘어 스킬 재사용으로: 자기진화 로봇 에이전트 (0) | 2026.10.01 |
| 📝 [EgoAlign] 사람 시연을 넘어 휴머노이드로: 로봇 없이 만든 학습 데이터 (0) | 2026.09.30 |


댓글