한 줄 요약: 실세계 실패를 진단·시뮬 재구성해 co-training과 RL로 VLA를 반복 개선하는 폐루프 프레임워크
🤖 VLA(Vision-Language-Action) 모델은 대규모 시연 데이터로 학습해 다양한 조작 작업을 수행하지만, 낯선 물체 배치·조명·방해물 같은 분포 밖(OOD) 상황에서는 쉽게 실패함. 흔한 해법은 실패 상황에서 사람이 교정 시연을 다시 수집하는 Targeted BC지만, 비용이 크고 위험하며 확장이 어려움. Real-to-Sim-to-Real 방식도 있지만, 수작업 시나리오나 광범위한 랜덤화는 실제 배포 중 겪는 실패 분포와 맞지 않는 경우가 많음.
이 논문은 "배포 중 관측된 실패 하나하나를 자동 진단해 상호작용 가능한 시뮬 환경으로 재구성하고, 그 주변에 학습을 집중하면 추가 실세계 시연 없이도 VLA를 지속적으로 개선할 수 있다"는 원리를 증명함!
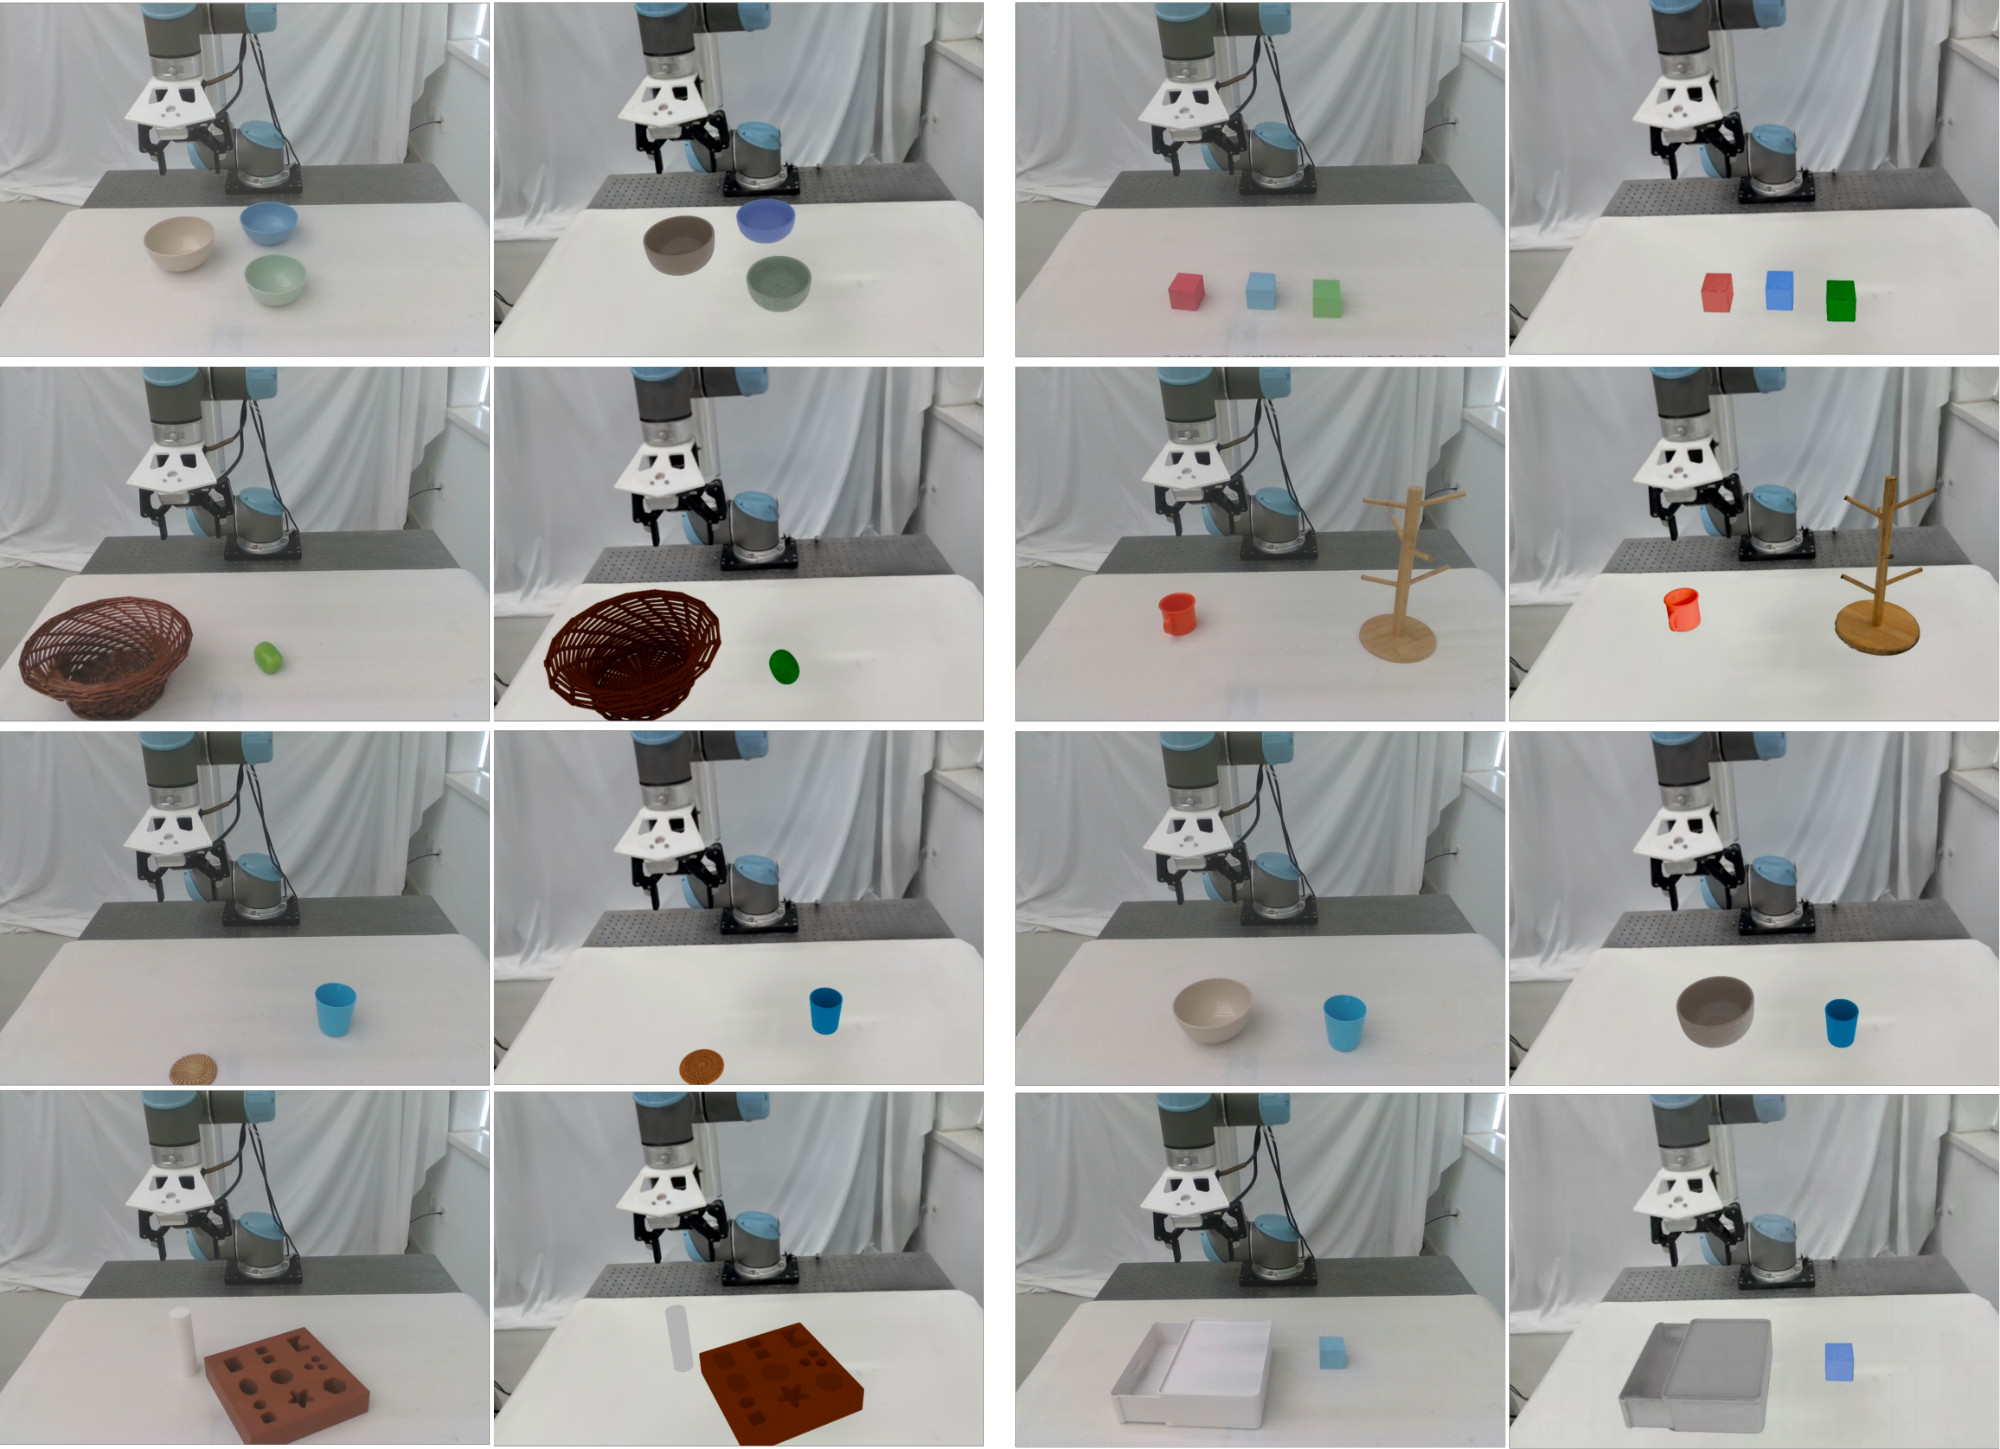
▲ Figure 9 · 8개 작업의 실제 장면과 재구성된 시뮬 장면을 나란히 비교함
💡 핵심 기술 요약
🔍 VLM-based Failure Diagnosis Agent: 이중 시점 영상을 시간순 증거 보드로 압축하고 GPT-5.5가 가장 이른 실패 시점·원인·장면 요인을 구조화된 JSON으로 출력.
🏗️ Failure-Guided Real-to-Sim Reconstruction: 3DGS 작업 공간과 손목 카메라 RGB-D 기반 물체 에셋을 Isaac Sim에 조립해 실패 조건을 그대로 복원한 사실적 상호작용 환경 생성.
🎯 Failure-Conditioned Co-Training + Targeted RL: 실패 주변만 국소 랜덤화한 환경에서 MimicGen 교정 궤적으로 sim-real co-training 후 PPO로 접촉 민감 행동까지 정제.
🔍 방법 자세히 보기
🧾 실패 인식과 진단 (Failure Recognition & Diagnosis)
작업별 이진 성공 판정기가 실패 롤아웃을 골라내면, 3프레임 간격으로 손목·외부 카메라의 그레이스케일 변화량을 계산해 상호작용이 일어난 구간 후보를 최대 10개 뽑음. 각 구간은 두 시점 프레임과 원본 프레임 번호를 붙인 최대 24시점의 증거 보드(Evidence Board)로, 시작·끝 8프레임은 상태 보드로 정리됨. 진단 에이전트는 구간별 호출, 상태 보드 호출, 가장 이른 양성 보드에 대한 집중 재질의, 텍스트 집계 호출 순으로 VLM을 부르며 뒤따르는 결과(물체 낙하 등)가 아닌 최초 원인을 찾도록 설계됨. 출력은 실패 시점, 대상 물체, 실패 작업 단계, 실패 유형, 장면 요인(pose·마찰·조명·시점·혼잡 등), 근거, 신뢰도로 구성된 실패 기록임.
🏠 실패 장면 재구성 (Failure Case Reconstruction)
작업 공간은 스마트폰으로 약 5분 촬영한 영상을 3D Gaussian Splatting으로 재구성하고, FPFH → Sim3 RANSAC → Sim3 ICP로 Isaac Sim 로봇과 정합함. 로봇 가우시안은 링크별로 라벨링되어 시뮬레이터의 링크 변환을 따라 움직이므로 렌더링이 시뮬 동작을 그대로 반영함. 이 1회성 촬영이 유일한 인간 개입 단계이며, 이후 재사용됨. 물체는 로봇이 손목 카메라로 자동 수집한 RGB-D를 TSDF 융합 → ShapeR 형상 완성 → Hunyuan3D PBR 텍스처 → 가우시안 최적화로 에셋화하고, 관절 물체는 VLM과 P3-SAM으로 운동 구조를 복원함. 진단된 장면 요인은 물체 자세·로봇 초기화·카메라·외관·물리 파라미터 벡터로 변환되어 실패 조건을 재현하는 환경으로 조립됨.
🎲 실패 인지 도메인 랜덤화 (Failure-Aware Domain Randomization)
재구성 장면 하나만으로는 과적합 위험이 있어, 실패 기록이 지정한 관련 변수만 복원된 설정 주변에서 샘플링하고 무관한 변수는 고정함. 예를 들어 그릇에 넣기 실패는 그릇 위치·개구 방향·물체 초기 자세를, 파지 중 미끄러짐은 마찰·질량·그리퍼 닫힘 속도를 랜덤화함. 여러 실패의 국소 분포를 균등 혼합한 실패 중심 분포가 교정 데이터 생성과 RL 상호작용 모두의 장소가 됨. 또한 재구성 환경에서 기존 정책 성공률이 70% 이하일 때만 실패가 재현된 것으로 인정하고, 세 번 연속 거부되면 광범위 랜덤화로 대체하는 검증·폴백 장치를 둠.
🧪 2단계 정책 정제: Co-Training → PPO
Stage I에서는 과거 실세계 성공 롤아웃을 시드로 MimicGen이 물체 중심 동작 구간을 랜덤화된 실패 환경에 맞게 변형하고, 파지 커버리지가 부족하면 AnyGrasp가 후보 파지를 보충함. 성공 궤적(작업당 380~450개)만 남겨 원래 실세계 데이터와 1:10 비율로 섞어 π0.5의 LoRA를 SFT함. Stage II에서는 co-trained 정책에서 출발해 256개 병렬 환경에서 원래의 희소 성공 보상만으로 PPO를 200 업데이트 수행하고, 실세계 데이터 SFT 손실(계수 0.1)을 보조로 더해 망각을 막음. 시연으로 먼저 어려운 실패 영역에 도달할 수 있게 만든 뒤 RL로 폐루프·접촉 행동을 다듬는 분업 구조임.
🔁 폐루프 재배포 (Closed-Loop Redeployment)
정제된 정책은 이전 실패와 새로운 설정에서 다시 배포되고, 여전히 남아 있거나 새로 생긴 실패는 다음 라운드의 진단·재구성·정제 입력이 됨. 작업 공간과 물체가 바뀌지 않았다면 장면·물체 에셋을 그대로 재사용하므로 이후 사이클은 약 10분의 시뮬 수집과 학습만 필요함. 이 반복으로 일회성 실세계 실패가 재사용 가능한 학습 자산으로 축적되고, 정책 개선 방향이 실제 운용 조건에 점점 맞춰짐.
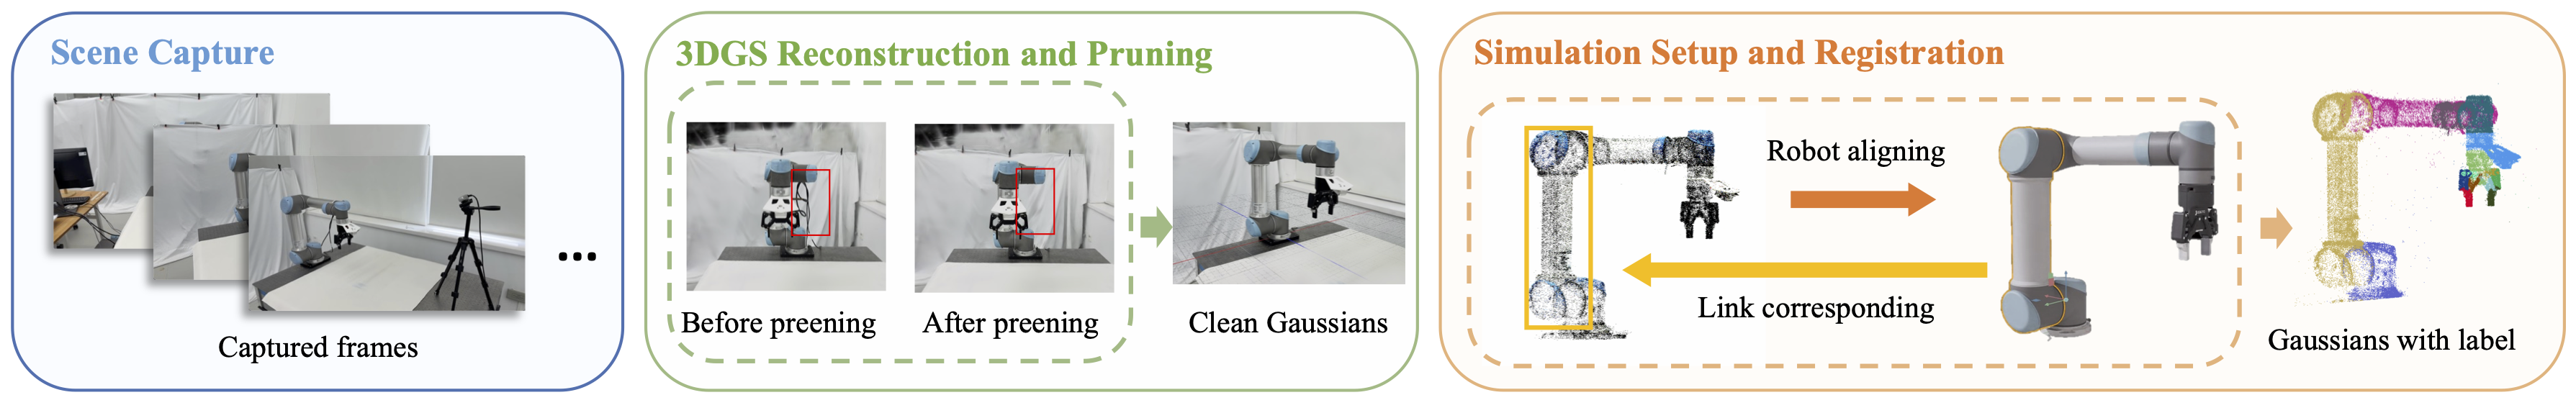
▲ Figure 5 · 3DGS 장면 재구성, 로봇 정합, 링크별 가우시안 구동 파이프라인
🧪 실험 설정
- 🦾 로봇/환경: UR5e + Robotiq 2F-85 그리퍼, 고정 3인칭·손목 RealSense D435i 2대. 시뮬은 Isaac Sim/Isaac Lab, 기본 정책은 π0.5(LoRA 미세조정).
- 📋 벤치마크: 8개 테이블탑 조작 작업으로 sim-real 일관성을 평가하고, 그중 Pick Fruits·Place Cup on Coaster·Stack Bowls·Place Block in Drawer 4개로 정책 정제를 평가함. ID는 수집 분포 내 설정, OOD는 배포 중 발견된 실패 설정(수집 범위 밖 yaw 등).
- ⚖️ 비교 대상: 실세계 교정 시연을 1시간 수집하는 Targeted BC, 동일 구조·예산으로 광범위 랜덤화 기반 co-training + RL을 하는 RLinf-Co. 모두 1시간 데이터 준비 시간으로 예산을 맞춤.
- 📏 평가 지표: 실세계는 설정별 20회 시도의 이진 성공률(블라인드 평가자 판정), 시뮬은 100개 병렬 환경 1회씩 롤아웃 성공률.
📊 주요 결과
🏆 예산 동일 조건에서 OOD 90% 달성: F4R은 ID 93.75%, OOD 90.0%를 기록해 Targeted BC(91.25% / 71.25%)와 RLinf-Co(87.5% / 77.5%)를 모두 앞섬. OOD 기준으로 각각 18.75, 12.5 포인트 높으며 추가 실세계 교정 시연은 0분임.
🗄️ 서랍 작업에서 두드러진 개선: 서랍 방향이 시연과 다른 Place Block in Drawer OOD에서 Base는 0%였으나 Targeted BC 60%, RLinf-Co 80%, F4R 85% 달성. 고정 시연으로 잡기 어려운 접촉 민감 행동에 시뮬 상호작용이 유효함을 보여줌.
🩺 자동 실패 진단 정확도 92.5%: 8개 작업 80개 실패 궤적에서 원인과 단계를 모두 맞힌 비율이 1회 시도 86.25%, 2회 이내 92.5%. 공개 ViFailback에서는 적응 없이 최고 백엔드(GPT-5.6-Terra)가 65.42%에 그침.
📈 다중 라운드 폐루프 개선: Stack Bowls는 3번의 사이클 동안 30% → 80% → 90% → 95%로 점진 상승하고, Pick Fruits는 첫 사이클에 40% → 100% 후 유지됨. 재구성 환경의 sim-real 성공률은 24개 체크포인트에서 Pearson r=0.7625(p=1.49×10⁻⁵)의 양의 상관을 보임.
| Method | ID Avg. (%) | OOD Avg. (%) | OOD Stack Bowls (%) | OOD Drawer (%) |
|---|---|---|---|---|
| Base | 62.5 | 26.25 | 30 | 0 |
| Targeted BC | 91.25 | 71.25 | 60 | 60 |
| RLinf-Co | 87.5 | 77.5 | 70 | 80 |
| F4R (Ours) | 93.75 | 90 | 80 | 85 |
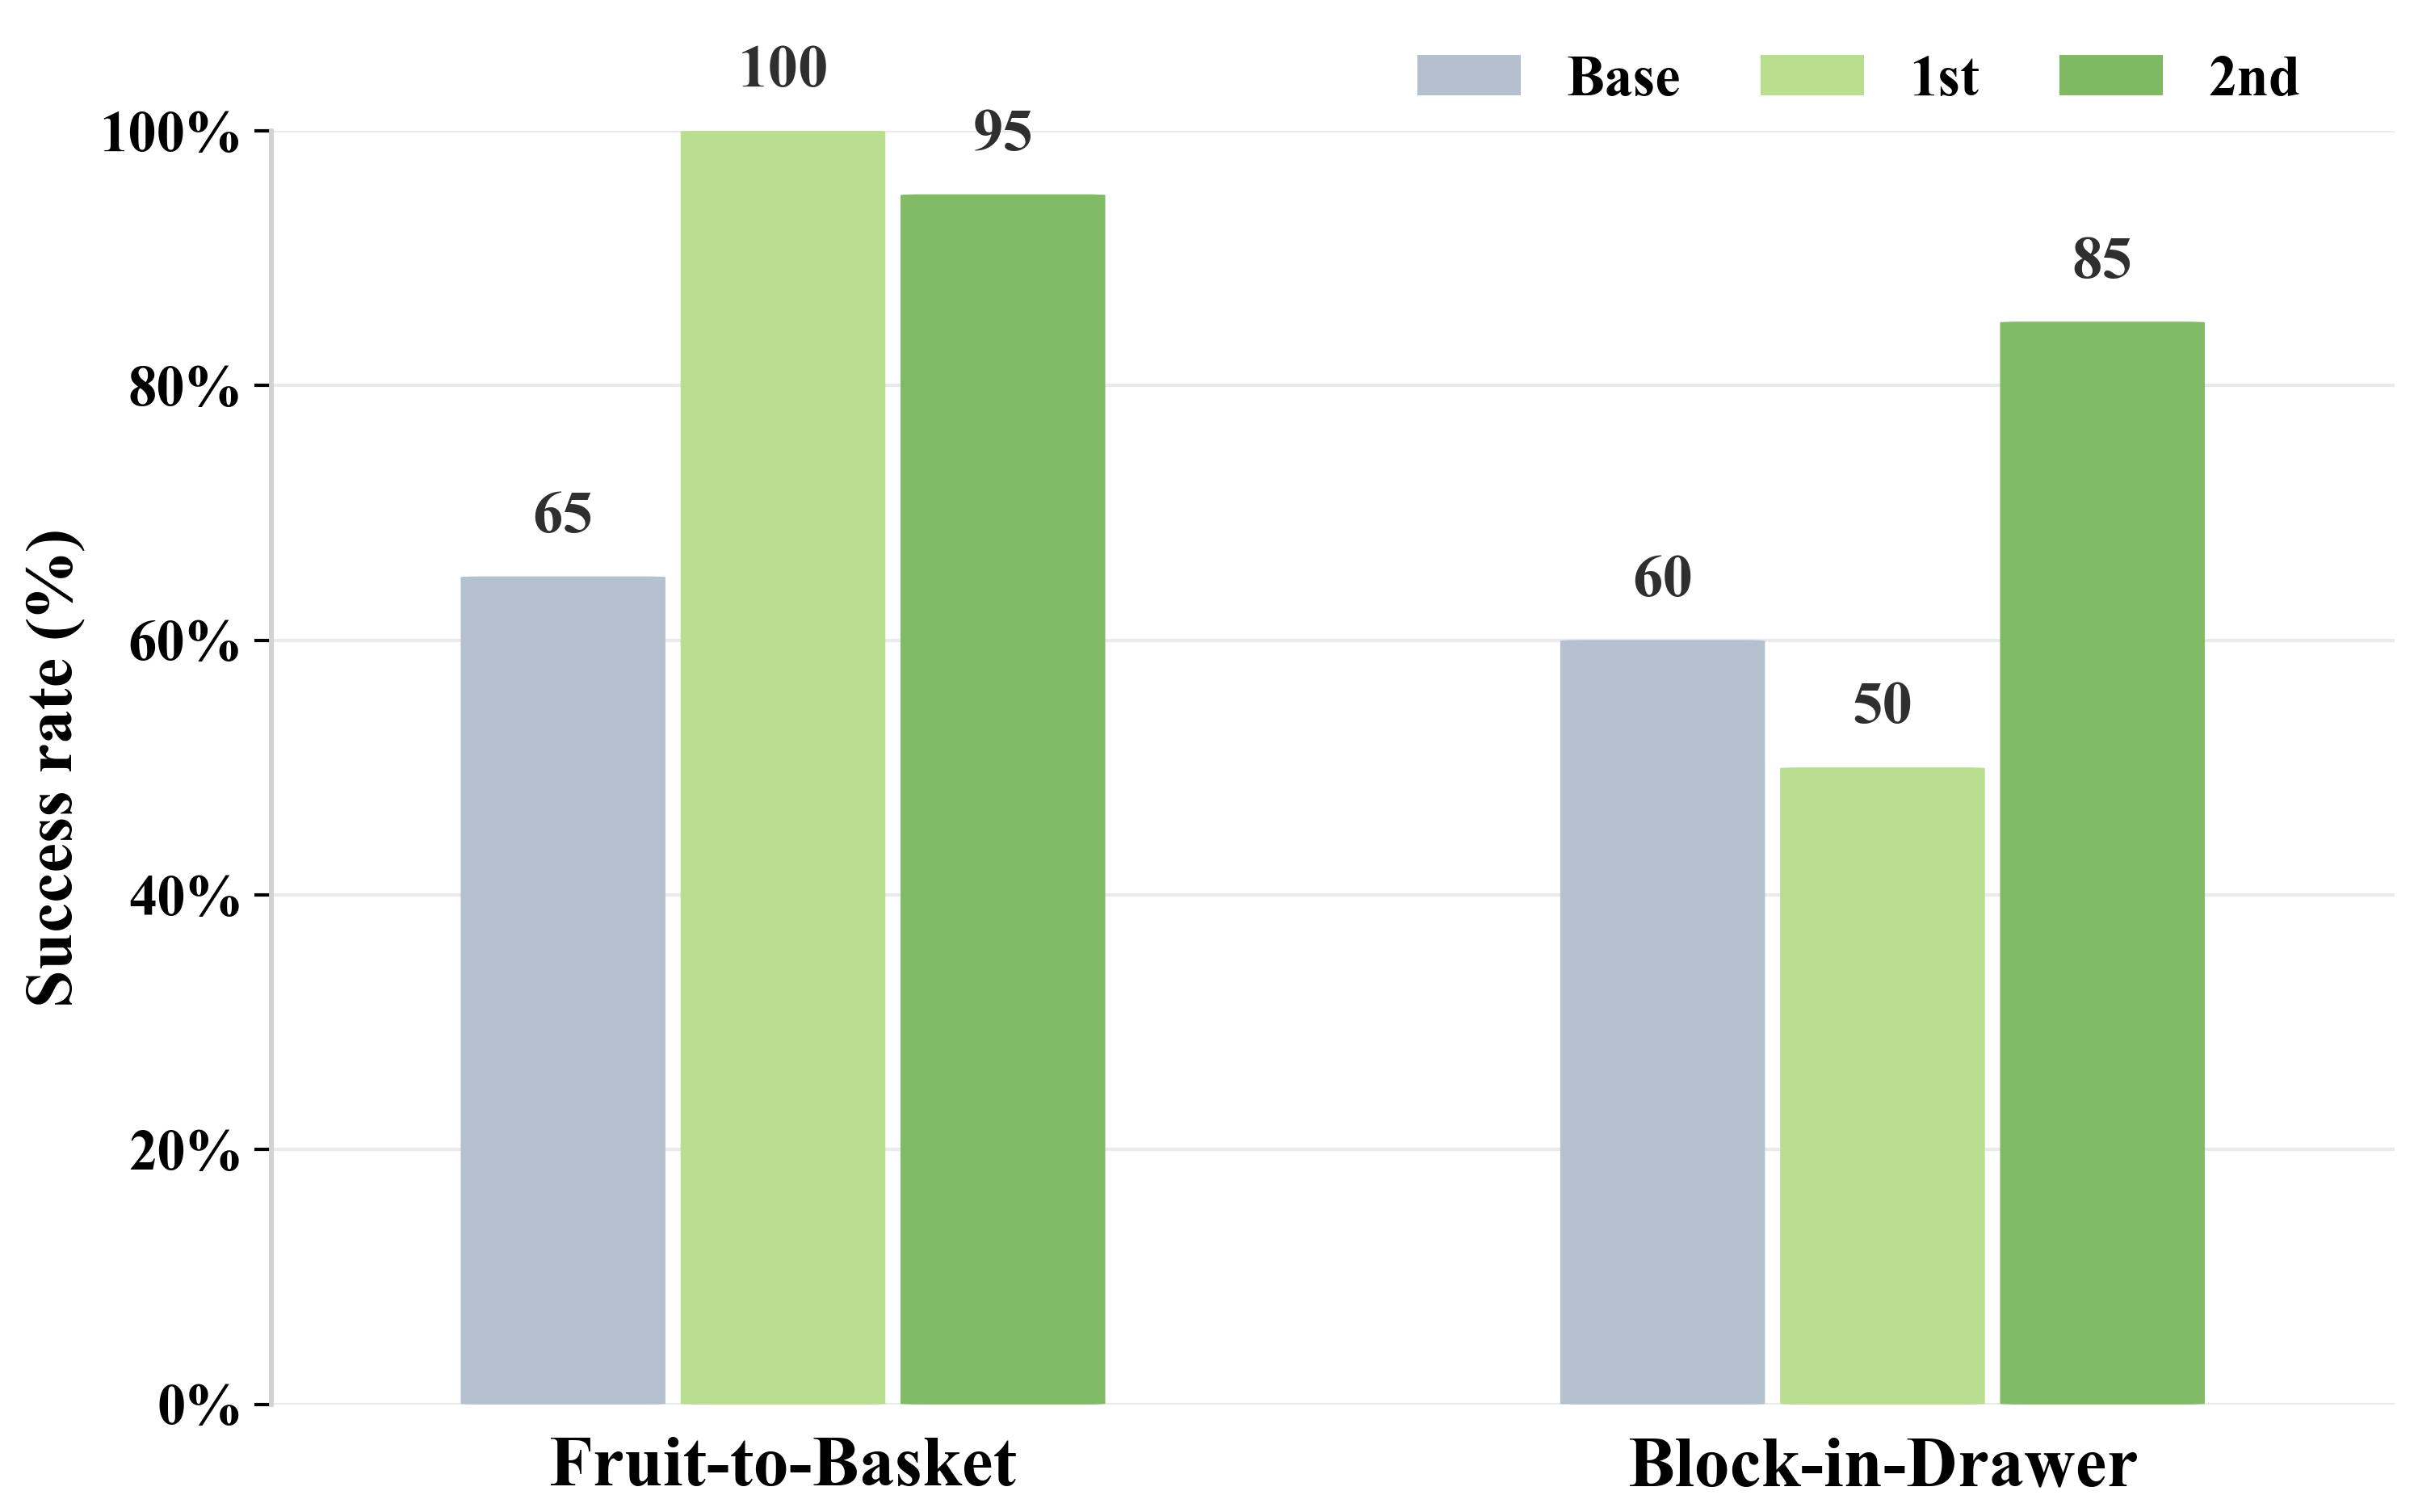
▲ Figure 10 · 두 번의 배포-정제 사이클에 따른 다중 작업 성공률 변화
🔬 분석 & Ablation
🧭 실패 진단 vs 실세계 데이터 감독: 실패 인지 랜덤화를 광범위 랜덤화로 바꾸면 ID 87.5%, OOD 77.5%로 각각 6.25, 12.5 포인트 하락해 진단이 OOD 실패 공략에 특히 중요함. 반면 실세계 데이터 감독을 빼면 ID는 85%로 8.75 포인트 떨어지지만 OOD는 86.25%로 3.75 포인트만 하락함. 실패 타깃 시뮬 데이터는 약점을 교정하고, 실세계 데이터는 주로 망각 방지 역할을 한다는 해석임.
🧩 Co-Training과 RL의 역할 분담: Stage I 없이 RL만 하면 ID 76.25%, OOD 32.5%로 OOD 개선이 6.25 포인트에 그침. 희소 보상 탐색만으로는 심각한 실패 영역에서 성공 행동을 찾기 어렵기 때문임. Stage I만 쓰면 90% / 83.75%로 대부분의 이득을 가져가고, Stage II RL이 3.75 / 6.25 포인트를 추가해 최종 성능에 도달함.
💡 실패 조건별 강건성: Pick Fruits의 네 가지 실패 유발 변형에서 평균 성공률이 Base 46.25%에서 F4R 90.0%로 상승하고, RL 없는 co-training만으로는 83.75%임. 물체 배치·배경은 co-training만으로 100%에 도달하고, RL은 조명(80→90%)과 방해물(55→70%) 조건에서 추가 이득을 줌.
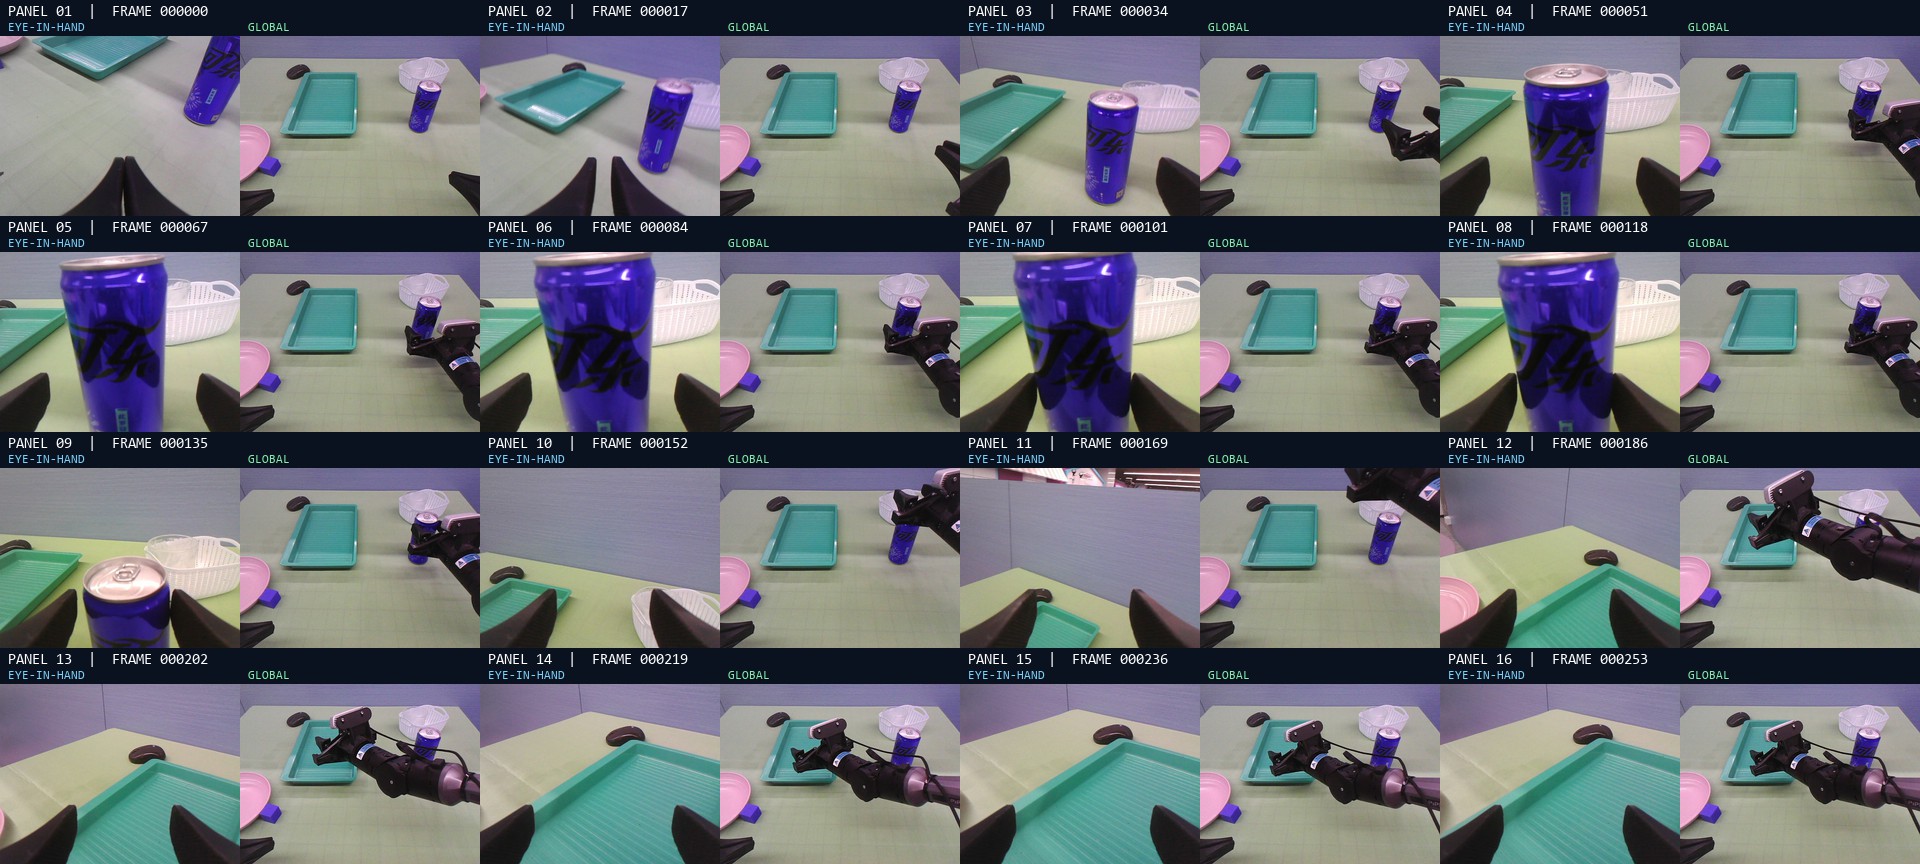
▲ Figure 3 · 올바른 진단 3건과 후속 결과를 원인으로 착각한 오류 2건 예시
⚖️ 논문이 밝힌 한계
👁️ 미묘한 시점·조명 변화에 약한 진단: 진단에 끝내 실패한 6개 궤적 중 4개는 카메라 시점 변화, 2개는 조명 변화였으며, 이전 프레임과의 세밀한 비교가 필요한 시간적 추론의 한계로 논문이 직접 지적함. 여러 실패가 동시에 일어나면 가장 이른 원인이 모호해지는 문제도 남음.
🧊 강체 테이블탑 중심의 적용 범위: 평가는 주로 강체 물체의 테이블탑 조작에 한정되며, 변형 물체·동적 장면·모바일 조작·장기 조립 작업에서는 검증되지 않음. 투명·반사·얇은 물체는 기하 재구성이 불완전하고 마찰·접촉 불일치로 인한 sim-real 격차도 남아 있음.
📚 누적되는 실패 메모리 관리: 배포가 진행될수록 실패 분포가 늘어 샘플링·학습 비용이 증가하므로 실패 분포의 병합·우선순위화·폐기 전략이 필요함. 향후 과제로 더 넓은 조작 도메인으로의 확장과 누적 실패의 효율적 재사용을 제시함.
⚡ 의의 및 실무 가치
🔄 실패를 학습 분포의 설계 신호로 전환: 기존 Real-to-Sim 연구가 장면·작업 단위로 환경을 고른 것과 달리, 배포 실패가 무엇을 재구성하고 어디에 학습을 집중할지 결정하는 폐루프를 구성함. 동일 예산의 광범위 랜덤화(RLinf-Co) 대비 OOD 12.5 포인트 우위로, 다양성보다 실패 정렬이 중요함을 실세계에서 보여줌.
🏭 현장 배포 로봇의 지속 개선, 교정 시연 수집이 위험하거나 비싼 공정 자동화, 실패 로그 기반 VLA 유지보수 파이프라인의 핵심 엔진!
🔗 원문 보기
F4R: Failure-Driven Recognition, Reconstruction, Refinement, and Redeployment for Continual Robot Self-Improvement
- 📄 arXiv: https://arxiv.org/abs/2609.35575
- 📥 PDF: https://arxiv.org/pdf/2609.35575v1
- 👥 저자: Zhuoyuan Yu, Jiacheng Wang, Tianle Liu, Yihua Ren, Peng Yu, Chen Bai 외 10명
- 📅 제출일: 2026-09-28 · cs.RO
'Vision-Language-Action > 논문리뷰' 카테고리의 다른 글
| 📝 [Uni-VLaT] 시각을 넘어 전신 촉각으로: 촉각 앵커 VLA 적응 (0) | 2026.09.30 |
|---|---|
| 📝 [CATok] 압축을 넘어 생성으로: Flow Matching 기반 인과적 액션 토큰 (0) | 2026.09.30 |
| 📝 [Holo-M] 연속 액션 전문가를 넘어 토큰으로: 휴머노이드 이산 VLA (0) | 2026.09.30 |
| 📝 [InfraVLA] 온보드 시야를 넘어 CCTV로: 인프라 카메라를 읽는 내비게이션 VLA (0) | 2026.09.30 |
| 📝 [View Collapse] 적대적 학습의 착시를 넘어: 멀티뷰 VLA의 View Collapse (0) | 2026.09.30 |


댓글