한 줄 요약: 건물 CCTV 영상을 토큰으로 넣고 2단계로 학습해, 로봇이 보지 못하는 목표와 막힌 통로를 파악하는 VLA
🏭 창고·병원·사무실에는 이미 CCTV가 곳곳에 달려 있어 로봇이 서 있는 자리에서는 안 보이는 통로와 방을 실시간으로 비춤. 그런데 최신 내비게이션 VLA(Vision-Language-Action)를 포함한 대부분의 정책은 로봇에 달린 온보드 카메라만 씀. 그래서 목표가 시야 밖에 있으면 통로를 하나씩 뒤져야 하고, 막힌 통로에 들어갔다가 되돌아 나오기도 함. 단순히 CCTV 인코더만 붙이면 정책이 CCTV 입력을 무시하는 지름길 학습(Shortcut Learning)에 빠지는 문제도 있음.
이 논문은 "사전학습된 내비게이션 VLA에 CCTV 전용 인코더를 붙이고 반사실(Counterfactual) 업샘플링과 복구 데이터로 2단계 학습하면, 로봇이 자기 카메라로는 볼 수 없는 정보를 활용해 길을 찾는다"는 원리를 증명함!
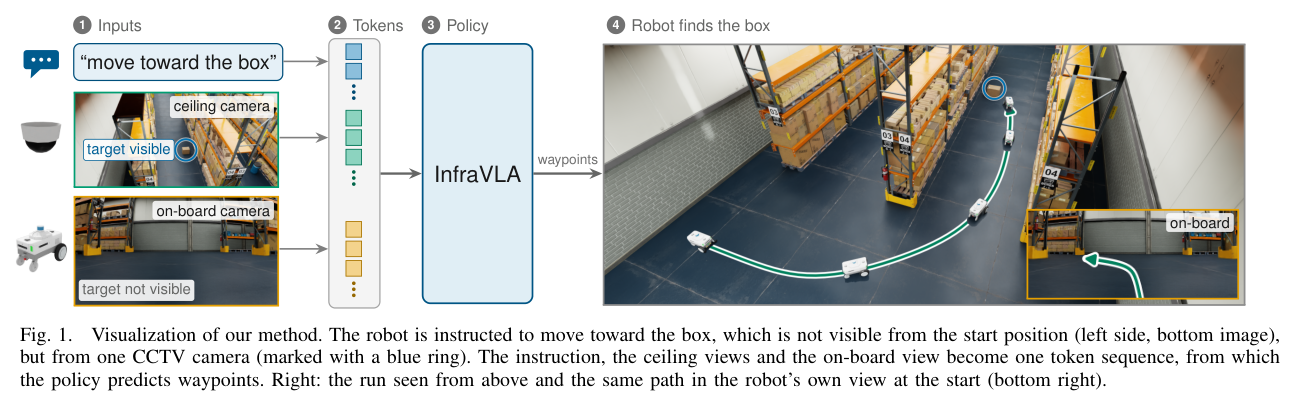
▲ Figure 1 · 온보드 카메라에선 안 보이는 박스를 CCTV로 찾아 이동하는 InfraVLA 개요
💡 핵심 기술 요약
📹 Dedicated CCTV Encoder: 뷰마다 전용 인코더로 256개 토큰을 뽑아 64개로 풀링한 뒤, 온보드 토큰 뒤에 끼워 LLM 백본에 end-to-end로 입력.
🔀 Counterfactual Snippet Upsampling: 같은 출발점에서 지시문·장면만 달라 경로가 갈리는 구간을 샘플링 비중 약 50%까지 올려, CCTV를 쓸 학습 유인을 만듦.
🛟 Recovery Data (HG-DAgger style): 1단계 정책이 경로를 벗어나면 A* 감독자가 복귀시키는 데이터를 분기 구간에서 모아, 카피캣(Copycat) 지름길을 제거.
🔍 방법 자세히 보기
🧱 베이스 모델: OmniVLA
OpenVLA에서 파생된 내비게이션 VLA인 OmniVLA를 기반으로 함. 온보드 이미지는 DINOv2와 SigLIP 특징을 이어 붙여 LLaMA 2 7B 임베딩 공간으로 투영하고, 목표는 언어 지시·목표 이미지·2D 목표 자세(Pose) 중 하나 이상으로 주어짐. 시퀀스 끝에 4H개의 0 토큰을 두고, 회귀 헤드가 이 위치의 출력으로 H=8개의 미래 웨이포인트(x, y, cosθ, sinθ)를 예측함. 추론 시에는 3Hz로 돌면서 5번째 웨이포인트를 역 유니사이클 모델로 선속도·각속도로 바꿔 로봇 속도 제어기에 전달함.
📹 CCTV 뷰를 토큰으로 넣는 구조
CCTV 이미지를 세그멘테이션이나 VLM으로 텍스트·그래프로 바꾸지 않고, 전용 인코더로 직접 토큰화해 중간 표현의 오류 전파를 막음. 온보드 뷰는 중요한 정보가 화면 앞쪽에 몰려 있지만, CCTV 뷰에서는 목표·막힌 통로·로봇 자신이 화면 어디에나 작게 나타날 수 있어 인코더를 따로 둠. 뷰당 256개 토큰을 2×2 평균 풀링으로 64개로 줄여 여러 카메라가 컨텍스트에 들어가게 하고, 사전학습 때의 위치를 유지하도록 온보드·목표 이미지 토큰 뒤에 삽입함. CCTV 인코더와 프로젝터는 온보드 쪽 가중치로 초기화해 처음부터 백본과 정렬되게 하고, 모든 선형 층은 LoRA로 미세조정함. 카메라의 내·외부 파라미터는 정책에 주지 않으며, 뷰와 로봇 좌표계의 관계는 데이터에서 학습함.
📉 손실 함수와 학습 유인 분석
OmniVLA의 손실에서 언어 추종 손실은 마지막 웨이포인트를 원점 쪽으로 끌어당기는 아티팩트가 생겨 제거함. 남은 손실은 웨이포인트 회귀 오차에 λ=0.1 가중의 평활화(Smoothness) 항을 더한 형태임. 논문은 CCTV 입력 Z를 쓰는 정책이 절약할 수 있는 손실이 온보드 관측 X가 주어졌을 때 행동과 Z 사이의 조건부 상호정보량 I(A;Z|X)와 같다고 정리함. 이 값이 작으면 CCTV를 무시하는 게 학습 목표상 최적이 되므로, 반사실 데이터로 이 값을 키우는 게 설계의 출발점임.
🔀 Stage 1: 반사실 스니펫과 업샘플링
같은 출발점에서 지시문이나 장면 구성만 바꿔 두 궤적을 기록하면, 경로가 갈라지기 전까지 온보드 뷰는 똑같고 CCTV나 지시문만이 다른 행동을 설명하게 됨. 두 궤적에서 같은 시점의 로봇 자세를 비교해 방향이나 거리 차이가 임계값을 넘는 지점 주변을 고정 길이 윈도로 잘라 반사실 스니펫(Counterfactual Snippet)으로 삼음. 이런 스니펫은 전체 데이터의 5.7~11.8%에 불과해 무시해도 손실이 낮게 나오므로, 데이터 로더에서 샘플링 비중의 약 절반이 되도록 업샘플링함. 전체 시연 데이터로 OmniVLA를 이렇게 미세조정해 정책 π1을 얻음.
🛟 Stage 2: 분기 구간 복구 데이터
행동 복제(Behavior Cloning)는 롤아웃 중 작은 오차가 누적되어 시연에 없던 상태로 빠지는 공변량 이동(Covariate Shift)에 취약함. 스니펫 안의 한 자세에서 π1을 출발시켜, 시연 경로와의 거리가 d_r=0.5m를 넘으면 이탈로 보고, 그 전 ε_on=0.05m 이내였던 마지막 시점과 이탈 시점 사이에서 무작위로 감독자가 개입함. 시뮬레이션에서는 A* 오라클이 경로로 되돌리고, 이 복귀 구간만 학습 데이터로 남김. K개 복구 궤적을 모으면 복구 데이터와 반사실 스니펫을 섞어 π1을 이어 학습해 π2를 얻음.
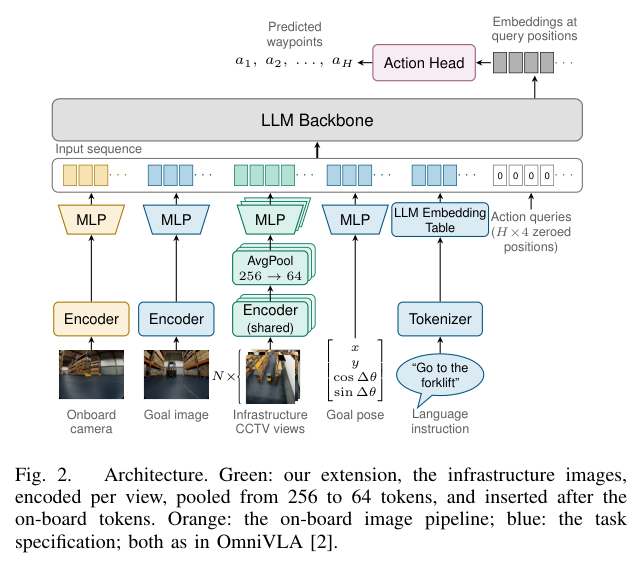
▲ Figure 2 · OmniVLA에 CCTV 인코더(초록)를 붙여 64토큰/뷰를 삽입하는 구조
🧪 실험 설정
- 🏗️ 시뮬레이션 환경: Isaac Sim의 50.8m×14.1m 창고, 구석 천장 7.89m 높이에 CCTV 4대(720×720), 차동 구동 로봇 Nova Carter 사용.
- 🎯 과제: Semantic 과제는 CCTV에서만 보이는 물체를 언어 지시로 찾아가는 것이고, Spatial 과제는 지게차로 막힌 통로를 피해 2D 목표 자세까지 우회하는 것임.
- 🐕 실제 로봇: Boston Dynamics Spot, 고정 카메라 2대, 물체 3종(화분·소화기·콘)에 대해 9분 53초 분량의 원격조작 시연 75개로 stage 1만 학습.
- ⚖️ 비교 대상: 같은 데이터·업샘플링으로 미세조정했지만 CCTV 인코더와 CCTV 입력이 없는 OmniVLA를 베이스라인으로 삼아 뷰 추가 효과만 분리함.
- 📏 평가 지표: 폐루프 롤아웃 성공률(목표 1m 이내, 실로봇은 운영자 판정), 선반과의 평균 최소 거리(Clearance), A*와 같은 통로를 지나는 비율(Route)을 측정함.
📊 주요 결과
📦 Semantic 과제 100% 성공: CCTV 없는 베이스라인은 34.0%로 통로를 찍는 확률 25%와 큰 차이가 없었지만, InfraVLA는 stage 1에서 100% 달성. Stage 2는 선반과의 평균 거리를 0.71m에서 1.27m로 늘림(시연 1.47m).
🚧 Spatial 과제 우회 성공: 베이스라인 73.6%, 최단 경로 비율 55.6% 대비 stage 2(K=24)는 성공률 100%, 최단 경로 비율 95.8% 달성. 복구 궤적 6개만으로도 성공률 100%, 최단 경로 비율 91.7%를 기록함.
🧭 분포 밖 일반화: 학습 때 제외한 배치(지게차가 좌상단 통로에 있는 경우)에서 88.2%, 제외한 막힘 패턴에서 88.9% 달성. 막힘 패턴 과제에서 stage 1은 33.3%에 그침. 학습에 없던 동의어 8개 중 7개가 66.7% 이상 성공함.
🤖 실제 Spot 로봇: 10분 미만 시연만으로 24회 중 20회(83.3%) 성공, 온보드만 쓰는 베이스라인은 7회(29.2%). 위에서 보면 빨간 원반처럼 보이는 소화기가 5/8로 가장 약했고, 실패는 모두 색이 같은 콘 앞에서 끝남.
| Policy | Semantic SR (%) | Semantic Clearance (m) | Spatial SR (%) | Spatial Route (%) |
|---|---|---|---|---|
| Fine-tuned OmniVLA (no CCTV) | 34.0 | 0.67 | 73.6 | 55.6 |
| InfraVLA, no upsampling | 36.0 | 0.62 | 76.4 | 51.4 |
| InfraVLA, upsampling (stage 1) | 100.0 | 0.71 | 77.8 | 44.4 |
| + recovery (stage 2) | 100.0 | 1.27 | 100.0 (K=24) | 95.8 (K=24) |
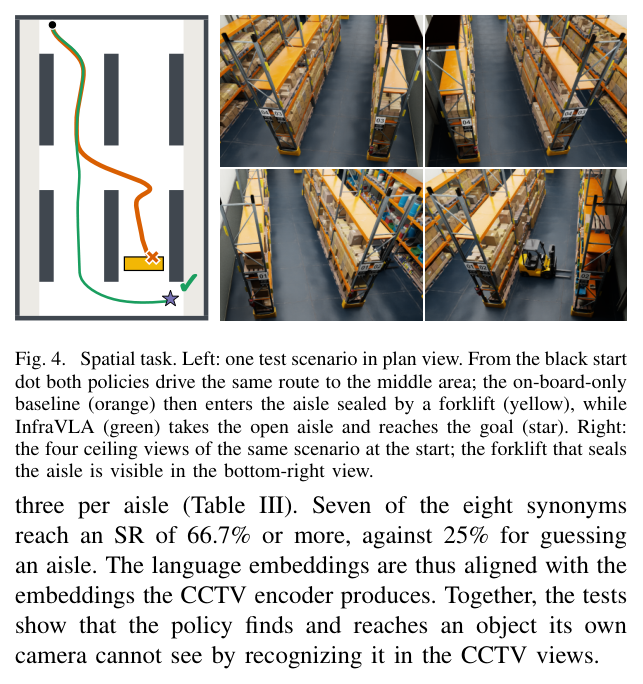
▲ Figure 4 · 막힌 통로로 들어가는 베이스라인(주황)과 열린 통로를 택한 InfraVLA(초록)
🔬 분석 & Ablation
🔍 인코더만 붙이면 CCTV를 무시함: 업샘플링 없이 학습하면 Semantic 성공률이 36.0%에 그침. 이때 반사실 스니펫의 검증 손실이 전체 검증 손실의 8.9배로, 분기 지점을 학습하지 못한 상태였음. 업샘플링 후에는 이 비율이 0.3배로 떨어졌고 성공률은 100%가 됨.
🐑 카피캣 지름길과 복구 데이터: Spatial stage 1 정책은 CCTV 대신 온보드 이미지 속 자기 진행 방향으로 통로 횡단 여부를 추론해 최단 경로 비율이 44.4%에 머묾. 한 쌍의 롤아웃에서 온보드 이미지와 CCTV를 서로 바꿔 넣은 오프라인 검증에서도 예측은 온보드 방향을 따라감. 스니펫만으로 5k 스텝을 더 학습해도 52.8%에 그쳤지만, 복구 데이터를 넣자 롤아웃 노이즈가 방향과 경로의 상관을 끊어 91.7~95.8%로 올라감.
🧪 아키텍처 Ablation: 뷰당 CCTV 토큰을 16개로 줄이면 성공률이 28.0%로 거의 찍기 수준이 되고, 온보드 인코더와 LLM을 함께 동결하면 26.0%로 떨어짐. 온보드 인코더만 동결하면 90.0%가 되고 5번은 선반에 충돌함. CCTV 인코더 공유(96.0%)와 CCTV 토큰 앞쪽 배치(94.0%)는 주로 국소 주행 품질이 나빠져 몇 번 실패함.
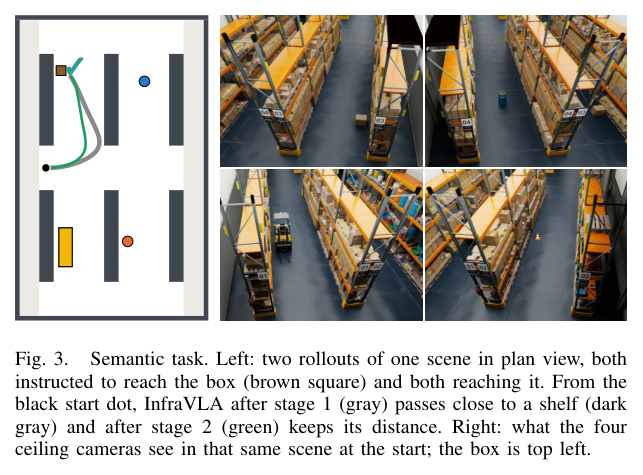
▲ Figure 3 · Stage 1(회색)보다 stage 2(초록)가 선반과 거리를 더 유지함
⚖️ 논문이 밝힌 한계
🎲 단일 학습 실행과 제한된 환경: 모든 결과가 학습 1회분이라 여러 시드에 대한 통계적 비교가 없음. 실험은 한 시설, 최대 4대 카메라로만 진행했고 언어 지시 과제는 고정 출발 자세라서, 더 큰 건물·더 많은 카메라·임의 출발점은 검증되지 않음.
⏱️ 추론 시간 증가: CCTV 4대를 붙이면 RTX PRO 6000 기준 추론 시간이 95ms에서 190ms로 두 배가 되고, 카메라 수에 따라 계속 늘어나 확장성이 제한됨.
🧩 실로봇 복구 데이터 미검증: 실제 로봇에서는 stage 2를 돌리지 않음. 넓은 공간과 더 많은 배치가 있어야 정책 자신의 이탈에서 복구 데이터를 모을 수 있는데 실험 환경이 작았음. 미리 정한 출발점에서 모은 복구 데이터는 오히려 성능을 떨어뜨림.
⚡ 의의 및 실무 가치
🌐 건물 인프라를 VLA 관측으로 편입: 외부 정적 카메라를 사전학습 내비게이션 VLA에 end-to-end로 넣은 첫 사례로 제시됨. 새 센서를 붙일 때 생기는 지름길 학습 문제를 조건부 상호정보량으로 설명하고, 반사실 업샘플링과 복구 데이터라는 구체적 처방을 내놓음. 사전학습 때 익힌 장애물 회피 능력도 유지됨을 정성적으로 보여줌.
🏥 물류 창고의 물품 탐색 로봇, 병원·사무실 배송 로봇, 막힌 통로를 미리 피하는 실내 자율주행 등 CCTV가 이미 깔린 시설용 로봇 내비게이션의 핵심 엔진!
🔗 원문 보기
InfraVLA: Extending Vision-Language-Action Navigation with Infrastructure Cameras
- 📄 arXiv: https://arxiv.org/abs/2609.33647
- 📥 PDF: https://arxiv.org/pdf/2609.33647v1
- 👥 저자: Lukas Vierling, Benjamin Ramtoula, Luke Robinson, Ronald Clark, Daniele De Martini
- 📅 제출일: 2026-09-27 · cs.RO
'Vision-Language-Action > 논문리뷰' 카테고리의 다른 글
| 📝 [F4R] 시연 재수집을 넘어 실패 재구성으로: 자가 개선 VLA 루프 (0) | 2026.09.30 |
|---|---|
| 📝 [Holo-M] 연속 액션 전문가를 넘어 토큰으로: 휴머노이드 이산 VLA (0) | 2026.09.30 |
| 📝 [View Collapse] 적대적 학습의 착시를 넘어: 멀티뷰 VLA의 View Collapse (0) | 2026.09.30 |
| 📝 [PSS] 전체 노이즈 대신 주요 응답 방향으로: 동결 정책 RL 적응 (0) | 2026.09.30 |
| 📝 [VLA-LRH] 정적 개념을 넘어 동역학으로: VLA의 선형 표상 가설 (0) | 2026.09.29 |


댓글